Article
Jev:一个故意不聊天的 AI 模型,和它在 Agent 里的位置
大多数新模型都在比谁更能说:更长、更像人、上下文窗口更大。TypeSafe 在 2026 年 9 月发的 Jev 反着来,官方文档直接写 jev-1.13「未被训练用于文本生成」,也不接多模态。
这不是没做完,是设计目标。TypeSafe 把它叫「System One 模型」,借的是卡尼曼《思考,快与慢》里那套快思考:自动、不占工作记忆,负责「这封工单要不要紧急处理」「这句话是不是越权」这种瞬间判断。Jev 不负责写回复,它负责判断。
输入输出:state 和 questions
TypeSafe 自己有句话总结得很好:
Unstructured state in, typed probabilistic decisions out.
翻译成大白话:你给它两样东西——state(业务现场,可以是一段自然语言、一个 JSON、或文本数组)和 questions(一组窄而明确的问题)。它不回你一段话,而是回类型化的结果:选了哪个选项、每个选项的概率、以及它对这个判断的把握(confidence)。你的代码拿这些数字自己决定下一步。
三个原语:Choice / Score / Noul
Jev 能问的问题只有三种形状,TypeSafe 叫它们原语(primitives)。
| 原语 | 在问什么 | 返回什么 | 典型场景 |
|---|---|---|---|
| Choice | 从你给定的封闭选项里挑一个 | 选中的选项 + 每个选项的概率 + confidence | 意图路由、工具选择、工单分类 |
| Score | 在一条有序量表上定位(2–10 档) | 位置(可落在两档之间)+ 各档概率 + confidence | 严重度评分、情绪强度、相关性打分 |
| Noul | 这句话为真的概率是多少 | 0 到 1 之间的一个数 | 是否紧急、是否违规、有没有证据支撑 |
三个细节。
同一个 state 可以在一次请求里并行塞多个问题。Smart Home Demo 里,一句「把客厅灯调成暖色并放首歌」会被同时判断类别、房间、设备、动作,再由代码把无关答案滤掉。
Noul 没有单独的 confidence 字段,那个概率本身就是把握,靠近 0.5 就是它自己也拿不准。
这件事的实际意义是:业务代码不用再写正则,或者拉第二个 LLM 去解析生成式文本,直接比概率、设阈值、排序、定路由就行。
和聊天模型、规则引擎的边界在哪
很多人第一反应:这不就是函数调用 / JSON mode 吗?差别在输出契约。
聊天模型的 function calling 本质还是生成 token,再靠 schema 往 JSON 上靠,你照样要防它偶尔漏字段、偶尔编一个枚举值出来。Jev 直接把输出收敛成「从封闭选项里挑一个 + 概率分布」,又明说自己不生成字符串,所以它给你的是类型安全的判断值,不是「一段尽量像 JSON 的话」。
那它替代规则引擎?也不是。规则引擎擅长格式确定、字段完整、阈值明确的事,比如金额大于 1000 就审批;Jev 补的是规则写不出来的那一块,比如「这条用户反馈是真抱怨还是随口吐槽」。这种话规则很难写,Noul 给个 0 到 1 的概率,代码再决定要不要升级。
短板官方也写明了:多层间接推理、字面含义、数值精度、日期先后、计数,它都吃力。所以算术、权限校验、事务提交、审计记录这些,还是交给确定性代码,Jev 不掺和。
最成熟的四类场景:路由、排序、验证、抽取
把官方文档、Cookbook 和 Demo 放一起看,Jev 现在最成熟的是四块。
- 路由与分类:意图分发、模型路由、客服分派。一次并行问多个分类问题,按 confidence 决定输出细类还是回退到粗类。
- 检索排序:给 RAG 召回的段落逐条打分。官方案例里 top-1 从 5% 升到 18%,top-10 从 38% 到 62%,注意这是官方自报。
- 结构化抽取:不让模型凭空生成值,而是代码先找出候选 span,Jev 从里面选一个,官方叫 select instead of generate。候选没覆盖到,它就没辙。
- 验证与门控:LLM guardrails、引用支持度检查、RAG 段落清洗(把藏在里面的注入指令识别出来丢掉)。
这些示例有个共同点:代码始终握着控制权,Jev 只出判断信号。官方没有哪个例子是「把整个任务丢给 Jev,它自己做完」。
核心工程模式:判断与执行分离
这是我觉得 Jev 最值得聊的部分。它不是端到端自动化,而是把语义判断压成一个能被审计的中间变量。
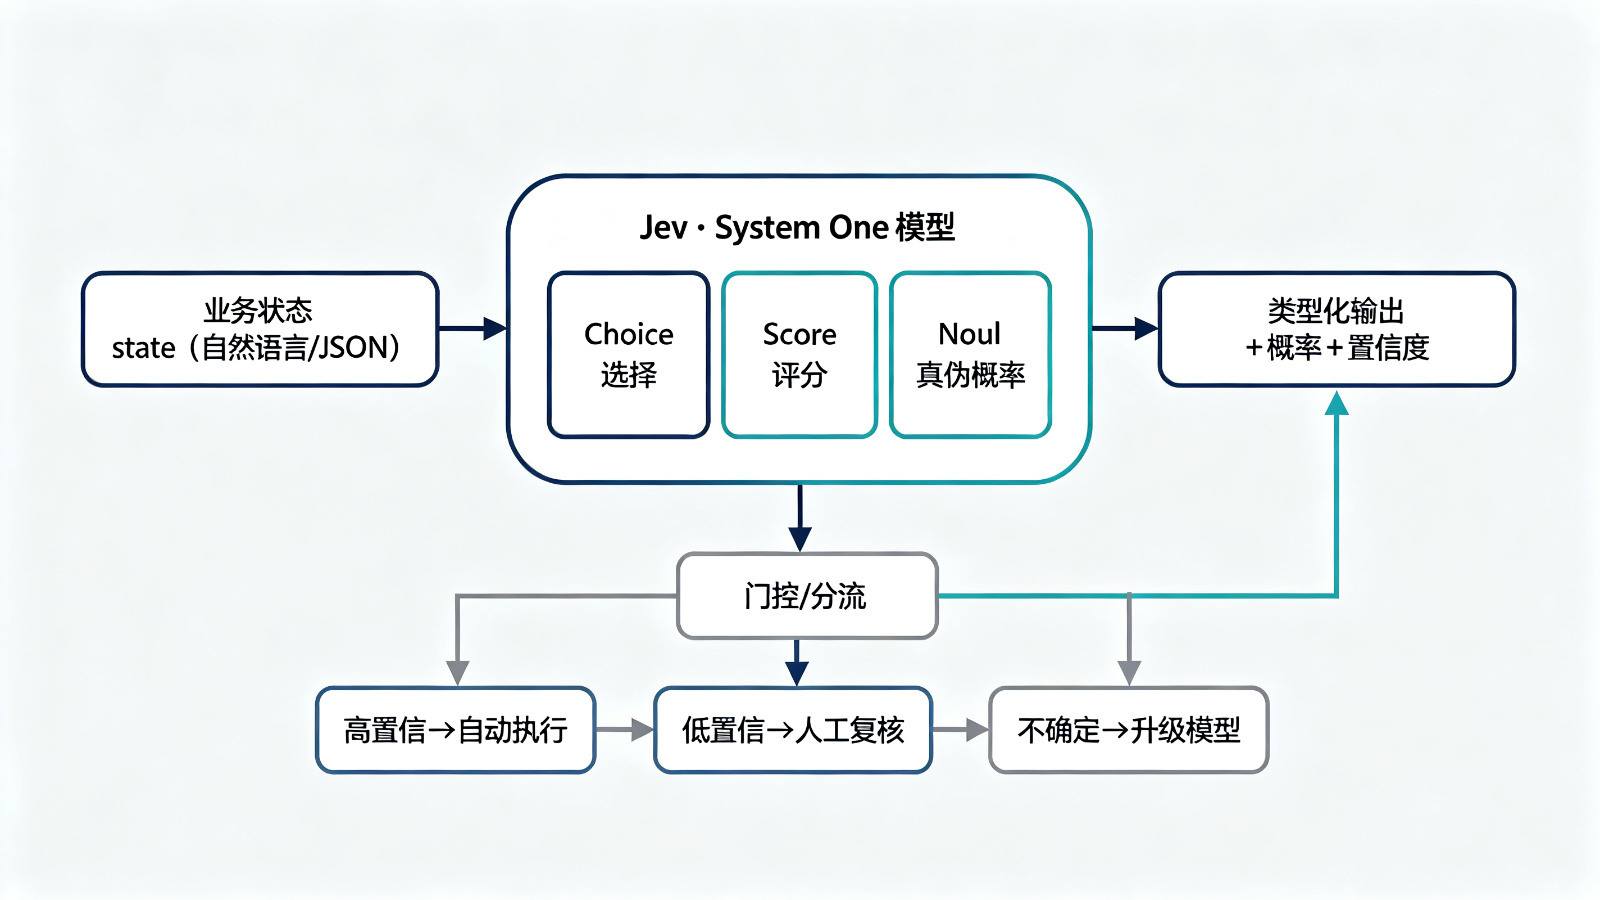
confidence 在这里是第二条决策轴:概率最高的那个选项,不代表就可以执行。
- 高置信:自动执行;
- 低置信、靠近阈值、候选没覆盖全:转人工复核;
- 明显不确定:升级到更强的模型,或者走兜底。
官方案例要把请求分到 75 个 SEC 行业细类,confidence 不够细分时,代码就回退到更宽的 division,而不是硬猜一个细类。生产里要的就是这种「通过 / 拒绝」之外的分层降级。
所以 Jev 的生产价值,不取决于单次输出多准,取决于阈值、复核队列、回退模型、人审流程这一整套周边怎么搭。
在 Agent 里:它最适合当门控层
这套模式放到 Agent 里,最值得先试的不是让它当大脑,而是把它摆在「真正产生副作用之前」那个位置:
- 工具 / 技能路由:先用确定性规则把权限和明显非法参数挡掉,再用 Choice 在合法工具里选一个。官方 Skill 示例会在 182 个技能里排序,把胜者注入 Agent 的 system prompt。
- 风险与质量门控:对越狱、提示注入、政策违规、工具调用错误做一次独立 Noul 判断,代码按概率决定放行、复核、阻断还是升级。
- RAG 与引用校验:给召回段落打分,矛盾的留下、注入的丢掉;再逐条 claim 判断这句话有没有证据撑着,撑不住就标记人审。
真正有副作用的动作——工具执行、改文件、调外部 API、付款、删除、发信——最终还是策略代码说了算,Jev 只给概率,不动手。
它不适合做什么
反过来,这些别硬塞给它:开放式写作和对话回复、长链推理、精确数值计算和日期间隔、任何要看图听音频的多模态任务。它在完整 Agent 里就是个局部、高频、答案空间窄的判断节点,不是决策中枢。
成本与现实边界
官方口径下,Jev 输入大约 0.042 美元一百万 token,输出免费,并宣称在 System One 类任务上比现有 LLM 快、高效两个数量级。但这几点得留个心眼:
- 这些速度、成本数字大多来自官方或第三方托管(Vercel AI Gateway、Cloudflare Workers AI)的自报案例,独立 benchmark、直连 SLA、区域部署、rate-limit 数据现在还不全;
- 概率和 confidence 得用自己业务域的标注数据去校准,别直接套 Cookbook 里的示例阈值;
- 模型别名 jev-latest / jev-preview 会随版本移动,生产环境建议 pin 住具体版本;
- 上下文是 64k(state 加全部 questions 合计)或 32k(state 加单个最长 question),设计问题时留点余量。
一点收尾
Jev 不是「又一个更便宜的大模型」。它真正有意思的地方,是把 AI 里最难处理的那部分——「做了判断但不好解释」——变成了类型化、能审计、能设阈值、能回退的东西。
对正在做 Agent 的人,我觉得更值得拿走的是这个思路:别急着让模型端到端干活,先把判断和执行拆开。模型给概率和置信度,代码做最后决定。用不用 Jev 另说,这个拆分本身就值得想一下。
参考
- TypeSafe — Introduction
- TypeSafe — Primitives (Choice / Score / Noul)
- TypeSafe — Introducing System One Models and Jev(官方博客)
- TypeSafe — Model Jaggedness: jev-1.13
- TypeSafe — Use-case Map
- TypeSafe — Patterns / Confidence-Gated Routing
- TypeSafe — Cookbook(rerank、guardrails、citation checking 等)
- LangChain — Building a Harness with Jev
Keep Reading