文章
从 0 到 1 搭建自己的 Coding Agent(二):Harness 是什么
你让 agent 修一个单位换算函数:输入 2m,应该返回 120 秒,现在却返回了 2。
它读了代码,改了函数,也跑了测试。接下来,你得知道几件具体的事:测试真跑起来了吗?失败信息有没有送回模型?它说「修好了」,有没有对应的执行结果?
假如命令已经失败,工具却只回了一段空文本,你再催一句「仔细检查」,帮助可能很有限。模型连刚才发生了什么都没看全。
上一篇拆开了最小循环。这篇往循环周围看一圈:怎样把模型接进一个能干活、能反馈、也能停下来的过程。
先给 Harness 划个范围
我在这个系列里把 Harness 叫作「模型周围的执行与反馈系统」。它组织模型要看的信息,把模型提出的动作交给工具,在边界内执行,再把结果带回来。任务状态怎么留、什么时候停止、拿什么验收,也需要在这套系统里安排。
这里的「系统」可以很薄。几段代码、几个脚本,再加上明确的输入输出约定,就已经有了一个小 Harness。装了多少插件,并不能直接说明它做得好不好。
也别把这个定义当成行业统一标准。不同文章、不同项目,说 Harness 时圈出来的范围会变。
OpenAI 拆解 Codex 循环的文章主要讲核心循环和执行逻辑。Anthropic 的长任务文章还讲启动脚本、进度文件和功能清单。OpenAI 的 Harness engineering 文章又把重点放到了仓库文档、架构约束和反馈工具上。
可以把它们理解成三个观察范围:程序怎么跑一轮,任务怎么跨会话接续,仓库怎样让 agent 找得到资料、验得出结果。这些范围有重叠,工程上也未必对应三个独立模块。
循环在里面,运行时把它跑起来
先回到刚才的单位换算任务。
模型负责理解 2m 的含义,读代码后提出修改,决定调用哪个工具。智能体循环(agent loop)负责接着问:模型要调工具,就执行并回传;模型得到新结果,再决定下一步。
运行时(runtime)把这些步骤落实到正在运行的任务上。它要管理会话、执行中的命令、取消信号,以及等待审批时的状态。上一篇讲的循环,是这里最容易看见的一部分。
Harness 的讨论范围通常更大,还会涉及喂给循环的项目指令、工具接口、工作区边界和验收入口。某个项目可能把这些全放进 runtime,另一个项目会拆成好几个包。读源码时先看职责,别只按目录名对号入座。
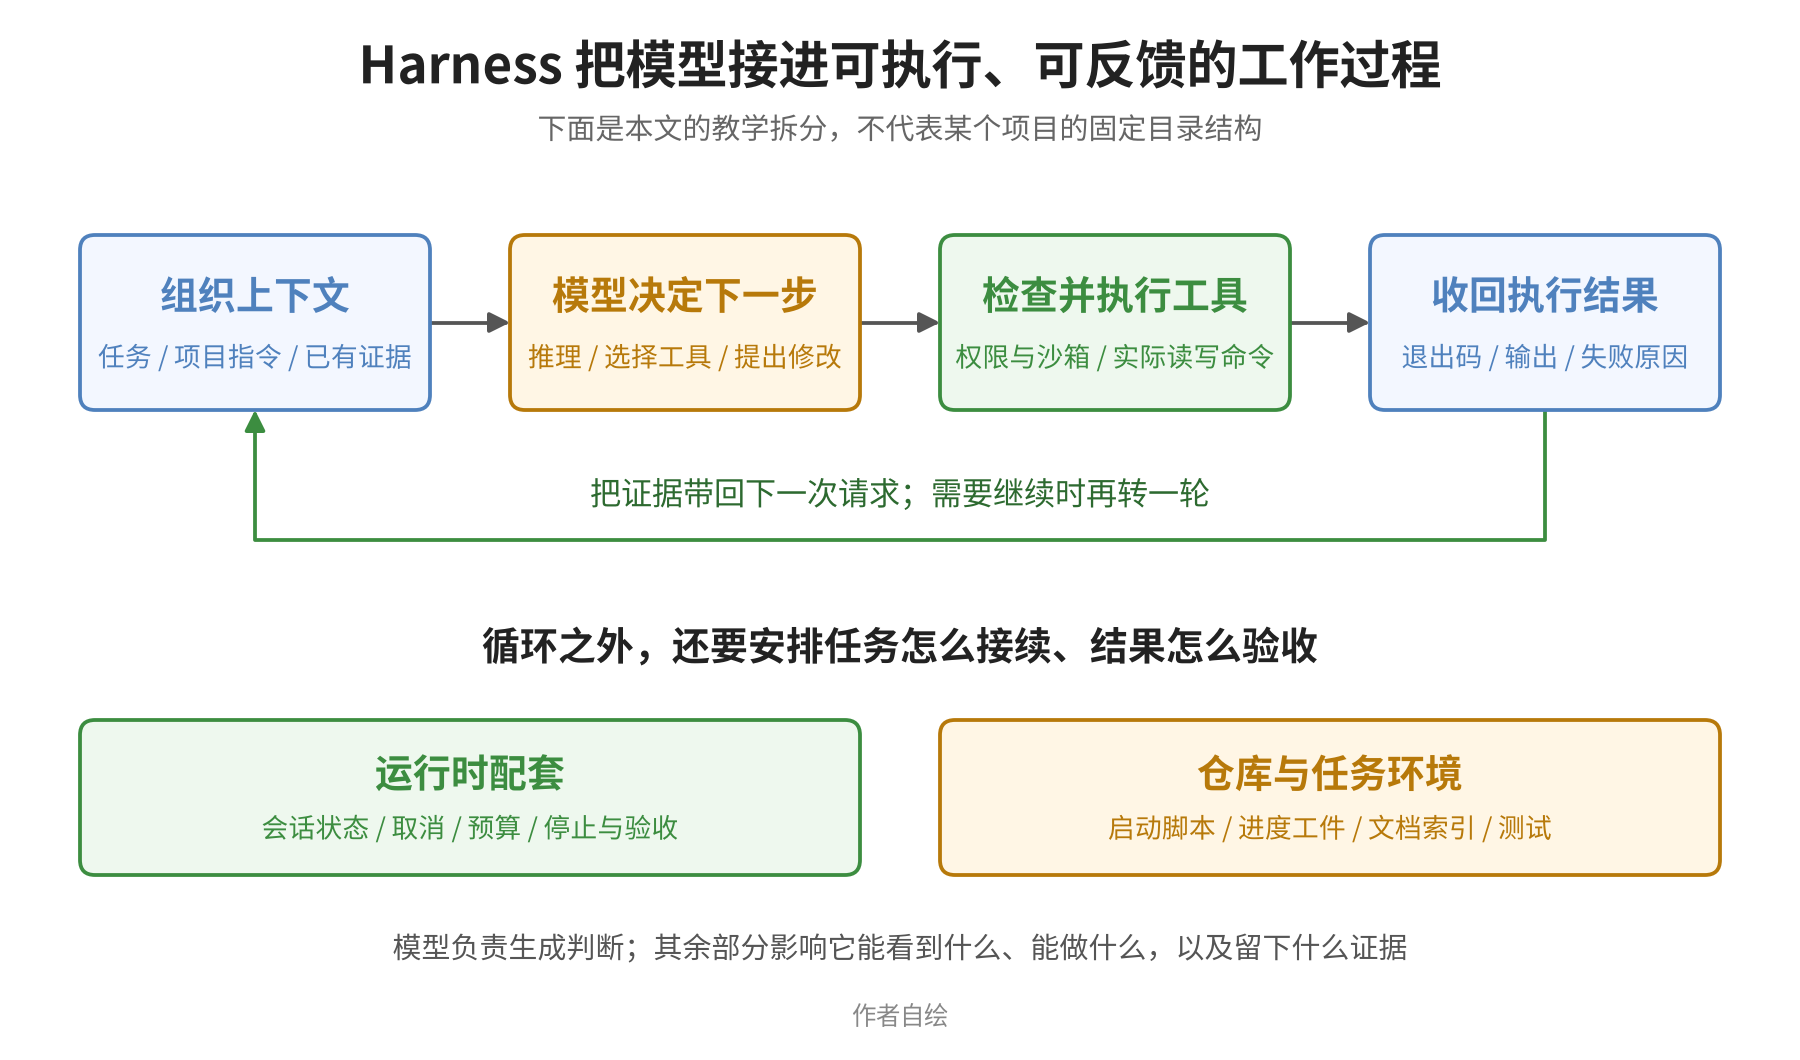
工具让模型有办法读文件、改文件、跑命令。权限策略决定一次动作能不能执行、需不需要确认,沙箱再限制进程实际能碰到哪里。只在提示词里写「别改工作区外的文件」,约束强度和操作系统拦住写入相差很大。
上下文决定这次请求能看到什么。测试失败了,但日志没回传;项目已经换了启动方式,但指令文件还指着旧命令,都会影响后续判断。把整个仓库塞进去也未必有帮助,相关材料能被找到、当前结果能被看见更要紧。
验收则提供完成的证据。对于这个小函数,至少可以跑一个断言,确认 2m 得到 120。测试覆盖之外有没有遗漏,仍要另看;一条通过的测试证明不了整个项目都正确。
这些能力可以由 Harness 内置,也可以接现成脚本。比如我的 Orca 在 orca exec 的合同文档里,把验证失败列成独立状态,并给它单独的退出码。程序需要把「生成完回复」与「检查通过」区分开。具体怎么验,留到验收篇展开。
为什么还要管仓库里的东西
你可能会问:启动脚本、项目文档、测试,本来不就是软件工程里的东西吗?
对,它们原本就有用。换成 agent 来执行,谁来发现它们、执行结果怎么回到下一轮,需要说得更明确。
Anthropic 在长任务实验里,让首次运行负责准备环境,留下 init.sh、功能清单和进度文件。后续会话先读进度和 git 历史,每次推进一项功能,再验证、留下记录。这是他们针对跨上下文窗口任务给出的一种做法,不能据此推成所有任务都要先建一整套文件。
小修复可能只需要一条清楚的测试命令。跨几天的功能开发,则可能需要持久的计划和进度。工件解决的是交接问题,文件多本身没有价值。
OpenAI 那篇仓库工程文章也有个实用的取舍:把 AGENTS.md 当目录,让 agent 沿着索引读相关文档;能机械检查的架构规则,交给检查器和测试执行。项目知识需要能被找到,硬规则需要能被检查。
所以,你不一定得改 agent 的核心代码,才能改进它的 Harness。补上可靠的启动脚本,暴露能查询的日志,把验收命令接进执行过程,都在改变它工作的条件。
换模型,还是改 Harness
如果模型已经读到了相关实现、失败日志和接口约定,仍然理解错了单位、写不出正确修复,换一个更适合这类任务的模型值得试。
如果它根本看不到测试错误,或者命令在错误的目录执行,先修这些环节更直接。更强的模型也许会主动追问、换个命令重试,但不能依赖它每次都猜出工具漏掉了什么。
两边也会相互影响。模型使用工具的方式不同,需要的工具说明和上下文组织可能不同。换模型后,原来的 Harness 需要重新验证,接得上 API 只说明请求能发出去。
我会先沿着一次失败的执行记录往回找:必要信息送到了没有,动作执行了没有,结果有没有如实返回。把这些确认后,再判断模型在哪一步理解错了。这样比较容易知道下一次该改什么,也能少做几轮没有依据的换模型实验。
实现上没有唯一形状。Pi自称极简、可扩展的 Harness,明确选择不内置子 agent 和计划模式。DeepSeek Harness(dsh)则连模型适配、工具注册、会话日志和循环本身都做成可替换插件。一个强调保留薄核心,一个把替换能力放进插件机制,各自有取舍。
我从 TypeScript 的 blade-code 做到 Rust 的 Orca,自己维护的是这套执行过程。若已有项目提供了合适的扩展点,补一个工具或反馈机制也可以从插件入手,用不着为了加一项能力就重写整个循环。dsh 仍处在开发者预览阶段,真要扩展它,接口要以使用时的版本为准。
做一个只改反馈的小实验
先不用调模型。下面这段代码故意漏掉了乘以 60,让同一次失败分别经过两种返回方式:只取标准输出,或者保留退出码、标准输出和标准错误。
import subprocess
import sys

code = """
import unittest

def minutes_to_seconds(text):
    return int(text.removesuffix('m'))

unittest.TestCase().assertEqual(minutes_to_seconds('2m'), 120)
"""
p = subprocess.run(
    [sys.executable, "-c", code],
    capture_output=True, text=True, timeout=5,
)
print("只给模型 stdout:", repr(p.stdout))
print("保留执行结果:", {
    "exit_code": p.returncode,
    "stdout": p.stdout,
    "stderr": p.stderr,
})
用 Python 3.9 或更新版本运行,第一种返回是空字符串。第二种能看到非零退出码,以及标准错误里的 2 != 120。函数写对之前,工具就已经有办法告诉模型失败在哪里。
再把返回值改成 int(text.removesuffix('m')) * 60,重新执行,退出码才变成 0。这个玩具例子只处理带 m 后缀的整数字符串,没有实现完整的时长解析器。
如果你已经搭了上一篇的循环,就把这两种返回方式接到同一个命令工具上,用同一个模型、同一份初始代码和同一个修复要求各跑几次。每次恢复初始文件,观察模型能否读到失败原因、下一步怎么选。别只比较最后一句「修好了」。
前半个实验展示信息会在哪里丢掉,后半个才是在观察模型如何利用反馈。它不保证某种返回格式一定让修复成功,也不能拿几次运行给模型排榜。
工具如果连失败都没留下,先把失败留下。等执行记录里能清楚看见那条 2 != 120,再看 agent 怎样把它修成 120,这次改动的作用就容易判断了。
继续阅读
讨论
读到这里时加载讨论。