Article
状态栏显示还剩 33%,请求却超了上下文上限
This model's maximum context length is 1048576 tokens. However, you requested
1048935 tokens (664935 in the messages, 384000 in the completion).
9 月 29 日,Orca 的一个会话连着两次收到这条错误。这是一个在 boss-skill 仓库里跑的会话:full-auto 模式,模型 deepseek-flash,思考强度 max,历史里已经有 902 条消息。同一时刻,Orca 底部的状态栏写着 ctx 33%。
两个数字说的是同一件事:上下文还剩多少。一个说已经超了,一个说还有三分之一。
384K 的回复预留,4K 的压缩假设
先把错误里的数字拆开:消息 664,935 个 token,回复预留 384,000 个,合计 1,048,935,比 DeepSeek 的上限 1,048,576 多出 359 个。
384,000 来自 deepseek_http.rs 里的 DEFAULT_CHAT_MAX_TOKENS,从 v0.3.1 起每个请求都带着它。DeepSeek 要求提示和回复预留加起来不超过 1,048,576,所以只要提示超过 664,576 个 token,请求就一定被拒,跟回复实际会写多长没有关系。
压缩的触发线用的是另一套假设。窗口按 1,000,000 算,软线是它的 80%,也就是 800,000;硬线是 90% 再减 4,096,也就是 895,904。这里的 4,096,是压缩逻辑以为的回复预留。
两套数字放在一起,664,576 到 800,000 之间多出一段 13 万多 token 宽的区间:落在里面的请求一定失败,压缩又一定不触发。这个会话正好停在里面。
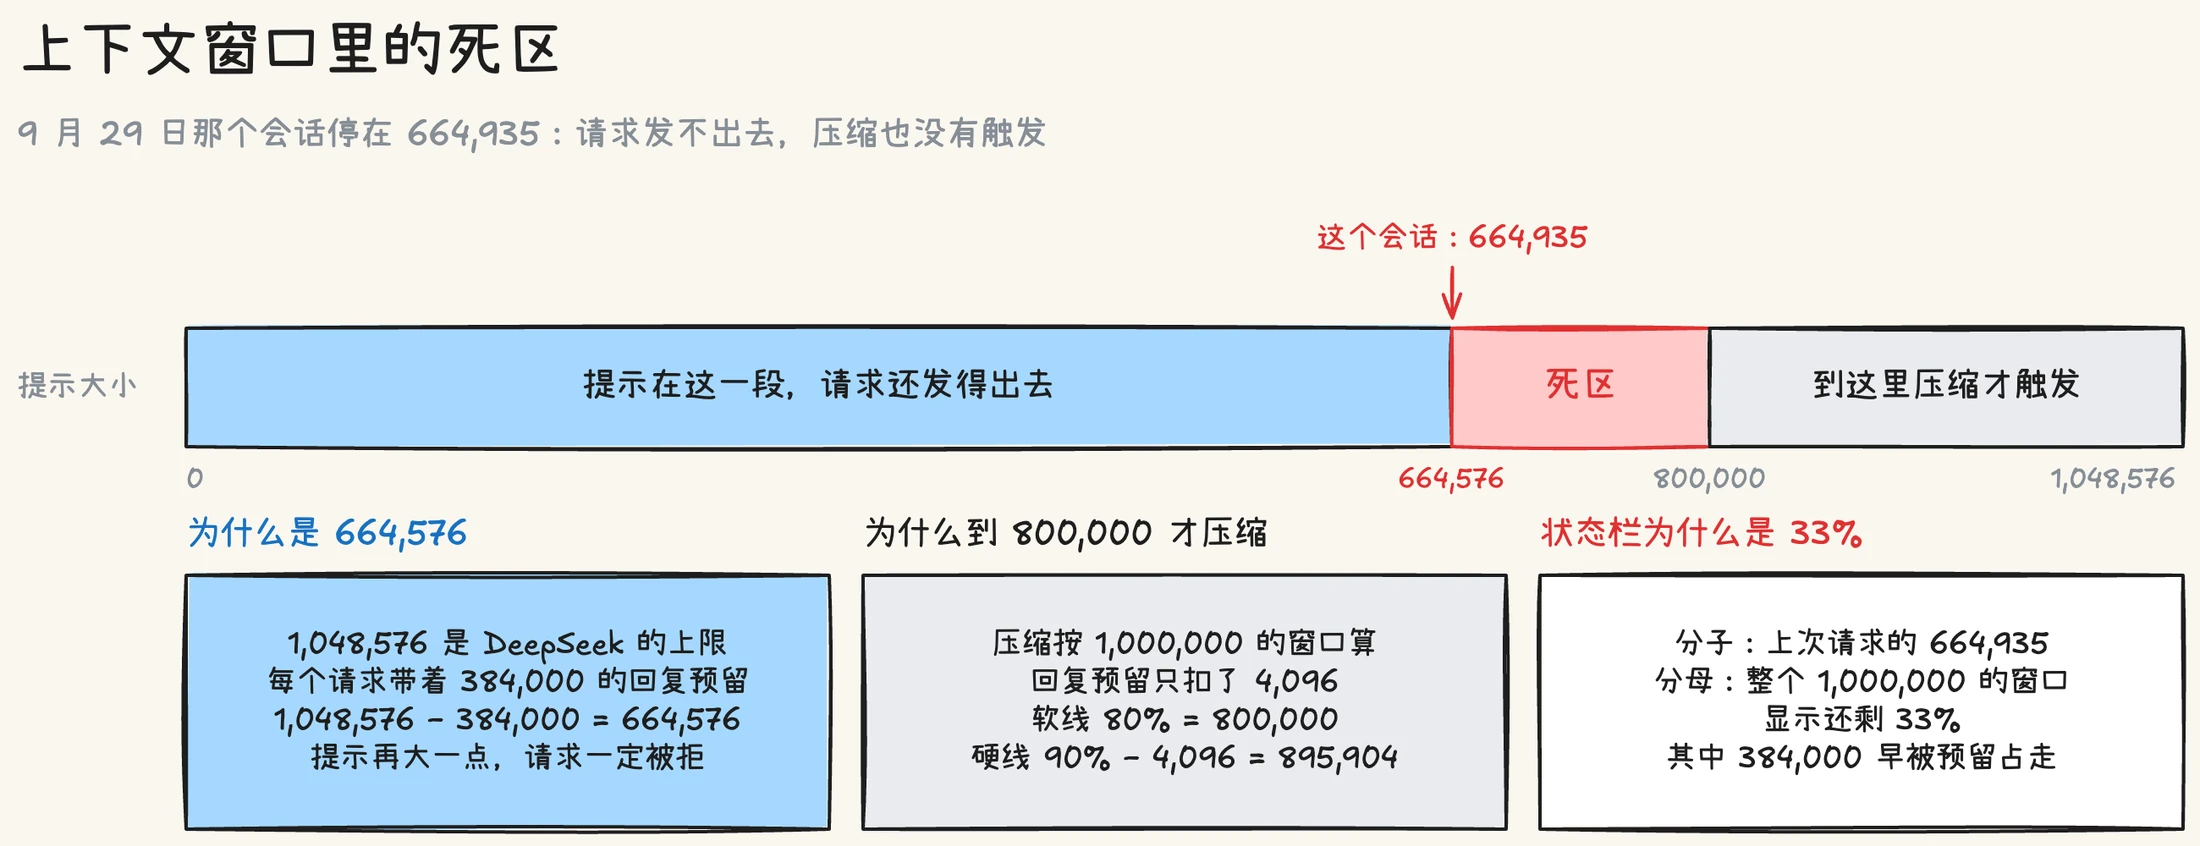
状态栏的 33% 是第三套口径:分子是上一次请求 API 报告的真实提示大小,分母是整个 1,000,000 的窗口。664,935 除以 1,000,000,剩下 33%。可分母里有 384,000 早就被回复预留占走了,实际能用的是 0。
这三处单看都说得通:回复预留往大了填,看上去最保险;80% 是常见的压缩线;仪表拿窗口做分母也很自然。出事是因为它们各算各的,没有一处知道另外两处的数字。
强制压缩:902 条进去,902 条出来
被拒之后本来有一条恢复路径:compact_and_persist 遇到 PromptTooLong,会强制压缩一次再重试。这次压缩的记录是:
before_messages 902, after_messages 902, collapsed 0一条也没压掉,重试原样失败。
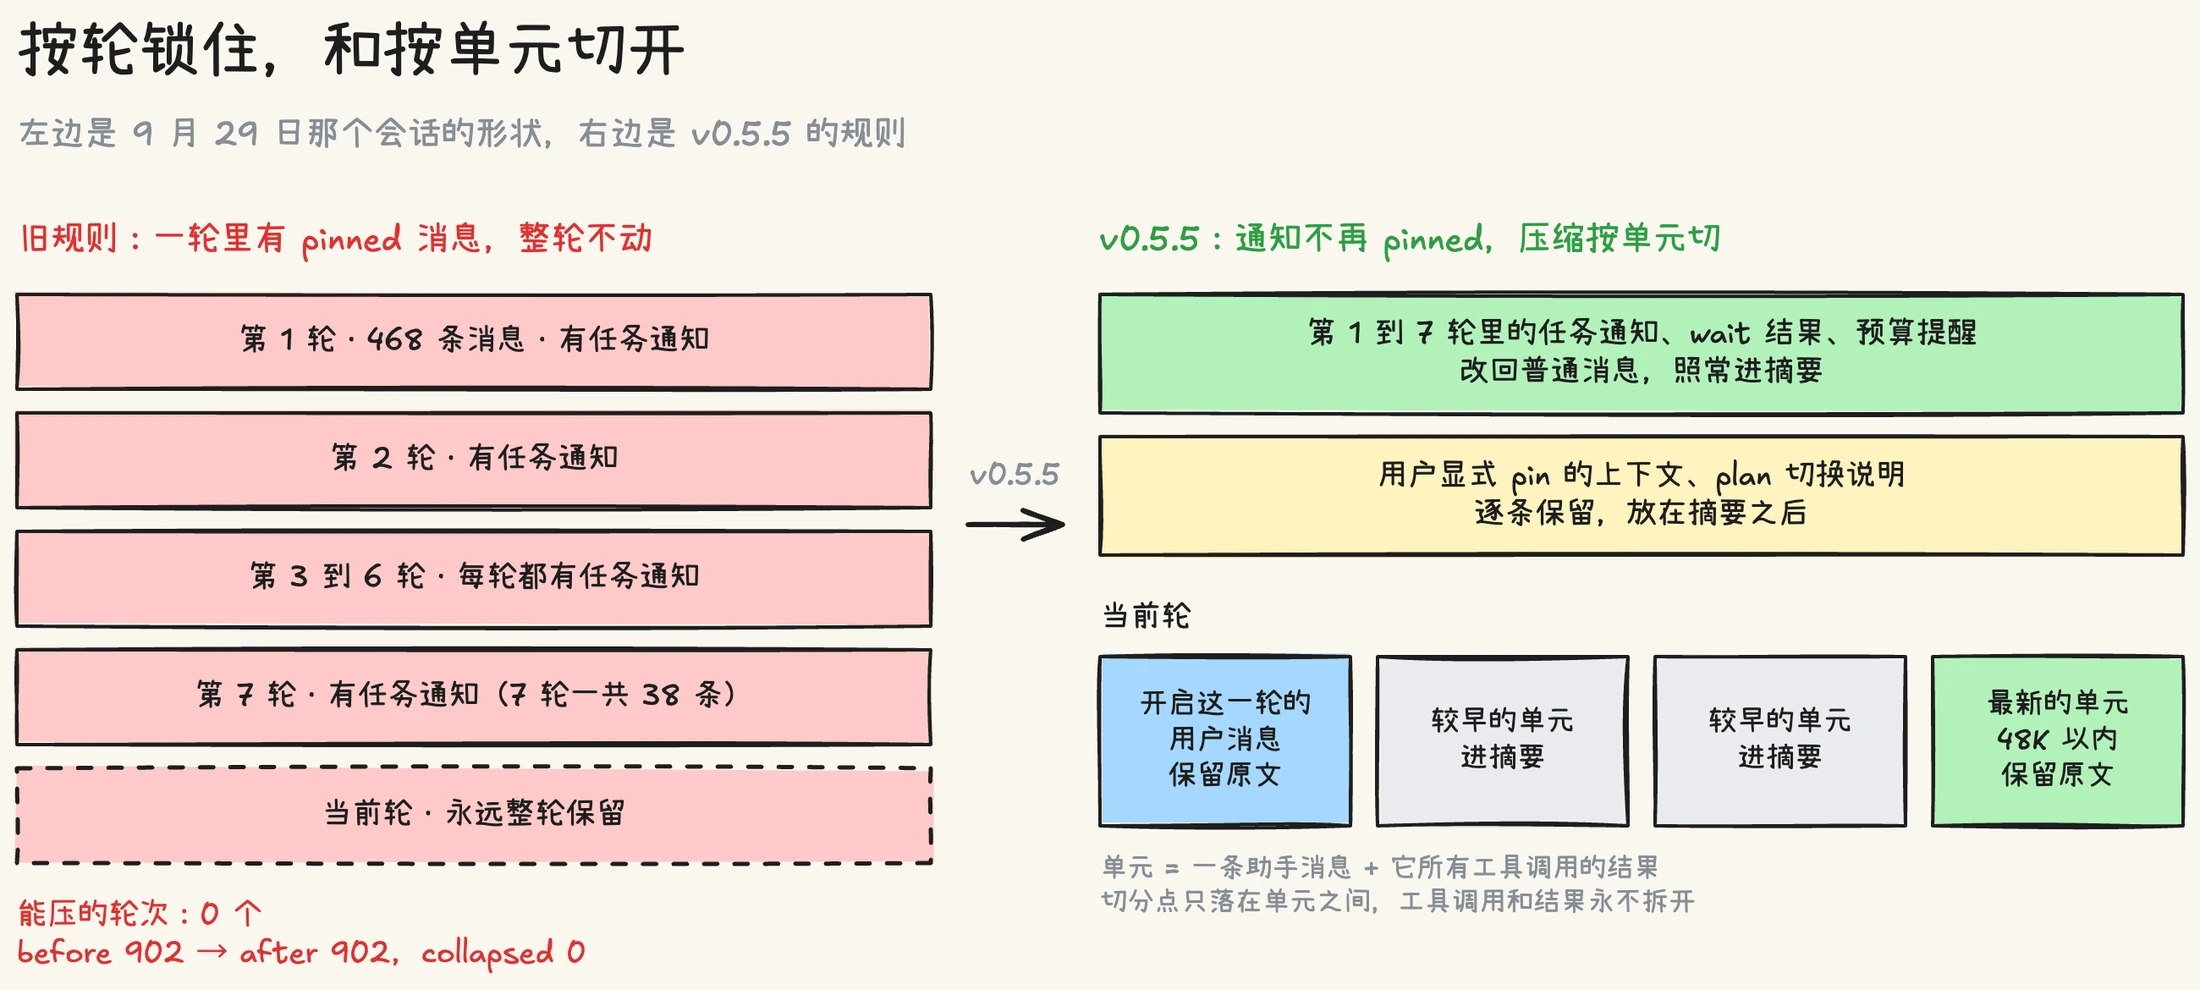
卡住它的是 pinned 消息。后台任务结束时,运行时会往对话里插一条完成通知,从 v0.3.23 起插的是 pinned system 消息;而压缩的规则是,一轮里只要有一条 pinned 消息,这一轮整个不动。这个会话的 7 个历史轮次,每一轮都至少有一条任务通知,一共 38 条。光第一轮就有 468 条消息,全在保护之下。
还有第二道锁:当前轮永远整轮保留。full-auto 或 goal 模式下,一轮里可能有几百次工具调用,这样的一轮单靠自己就压不动。
能压的只有既没有通知、又不是当前轮的轮次,这个会话里一个也没有。/compact 走的是同一套规则,同样压不动。从这一刻起,每个新请求都至少和上一个一样大,这个会话再也发不出请求了。
dsh 和 Codewhale 先扣掉了预留
动手改之前,我先看了 dsh 和 Codewhale(原名 DeepSeek-TUI)怎么算这笔账。
DeepSeek 官方的 dsh(本机 dsh-v0.1.7-rc.2 的源码)给每个请求的输出上限是固定的 256,000(llm-deepseek 包里的 DEFAULT_MAX_TOKENS)。它的压缩压力线默认取窗口的 80%,同时封顶在「窗口 − 输出预留 − 65,536」。回复预留越大,压缩线越往下挪。
Codewhale 0.9.0(2026 年 7 月 16 日)的更新日志里记过同一类问题,修法也一样:自动压缩的阈值锚定在扣掉输出预留和安全余量之后、真正能花的输入预算上,好让输出预留很大、或者窗口很紧的路线,在服务端拒绝之前先压缩。
Orca 缺的就是这一步:压缩线从来没扣过真实的回复预留。
预算只在一处算
v0.5.5 把预算收到 ContextConfig 一处,触发线、每次请求的回复预留、仪表的上限都从这里推出来。
回复预留 R 不再是 384K,按思考强度给:
| 思考强度 | 回复预留 R |
|---|---|
| Max | 131,072 |
| High | 65,536 |
| Low | 32,768 |
默认值不超过窗口的 15%,可以用 [model_runtime] max_output_tokens 覆盖,取值限制在 16,384 到 384,000 之间。
触发线 T 还是原来的公式 min(0.8W, 0.9W − R),区别是 R 换成了真实的预留,不再写死 4,096。窗口 W 按 1,000,000 算,Max 强度下 T 是 768,928,High 和 Low 下是 800,000。
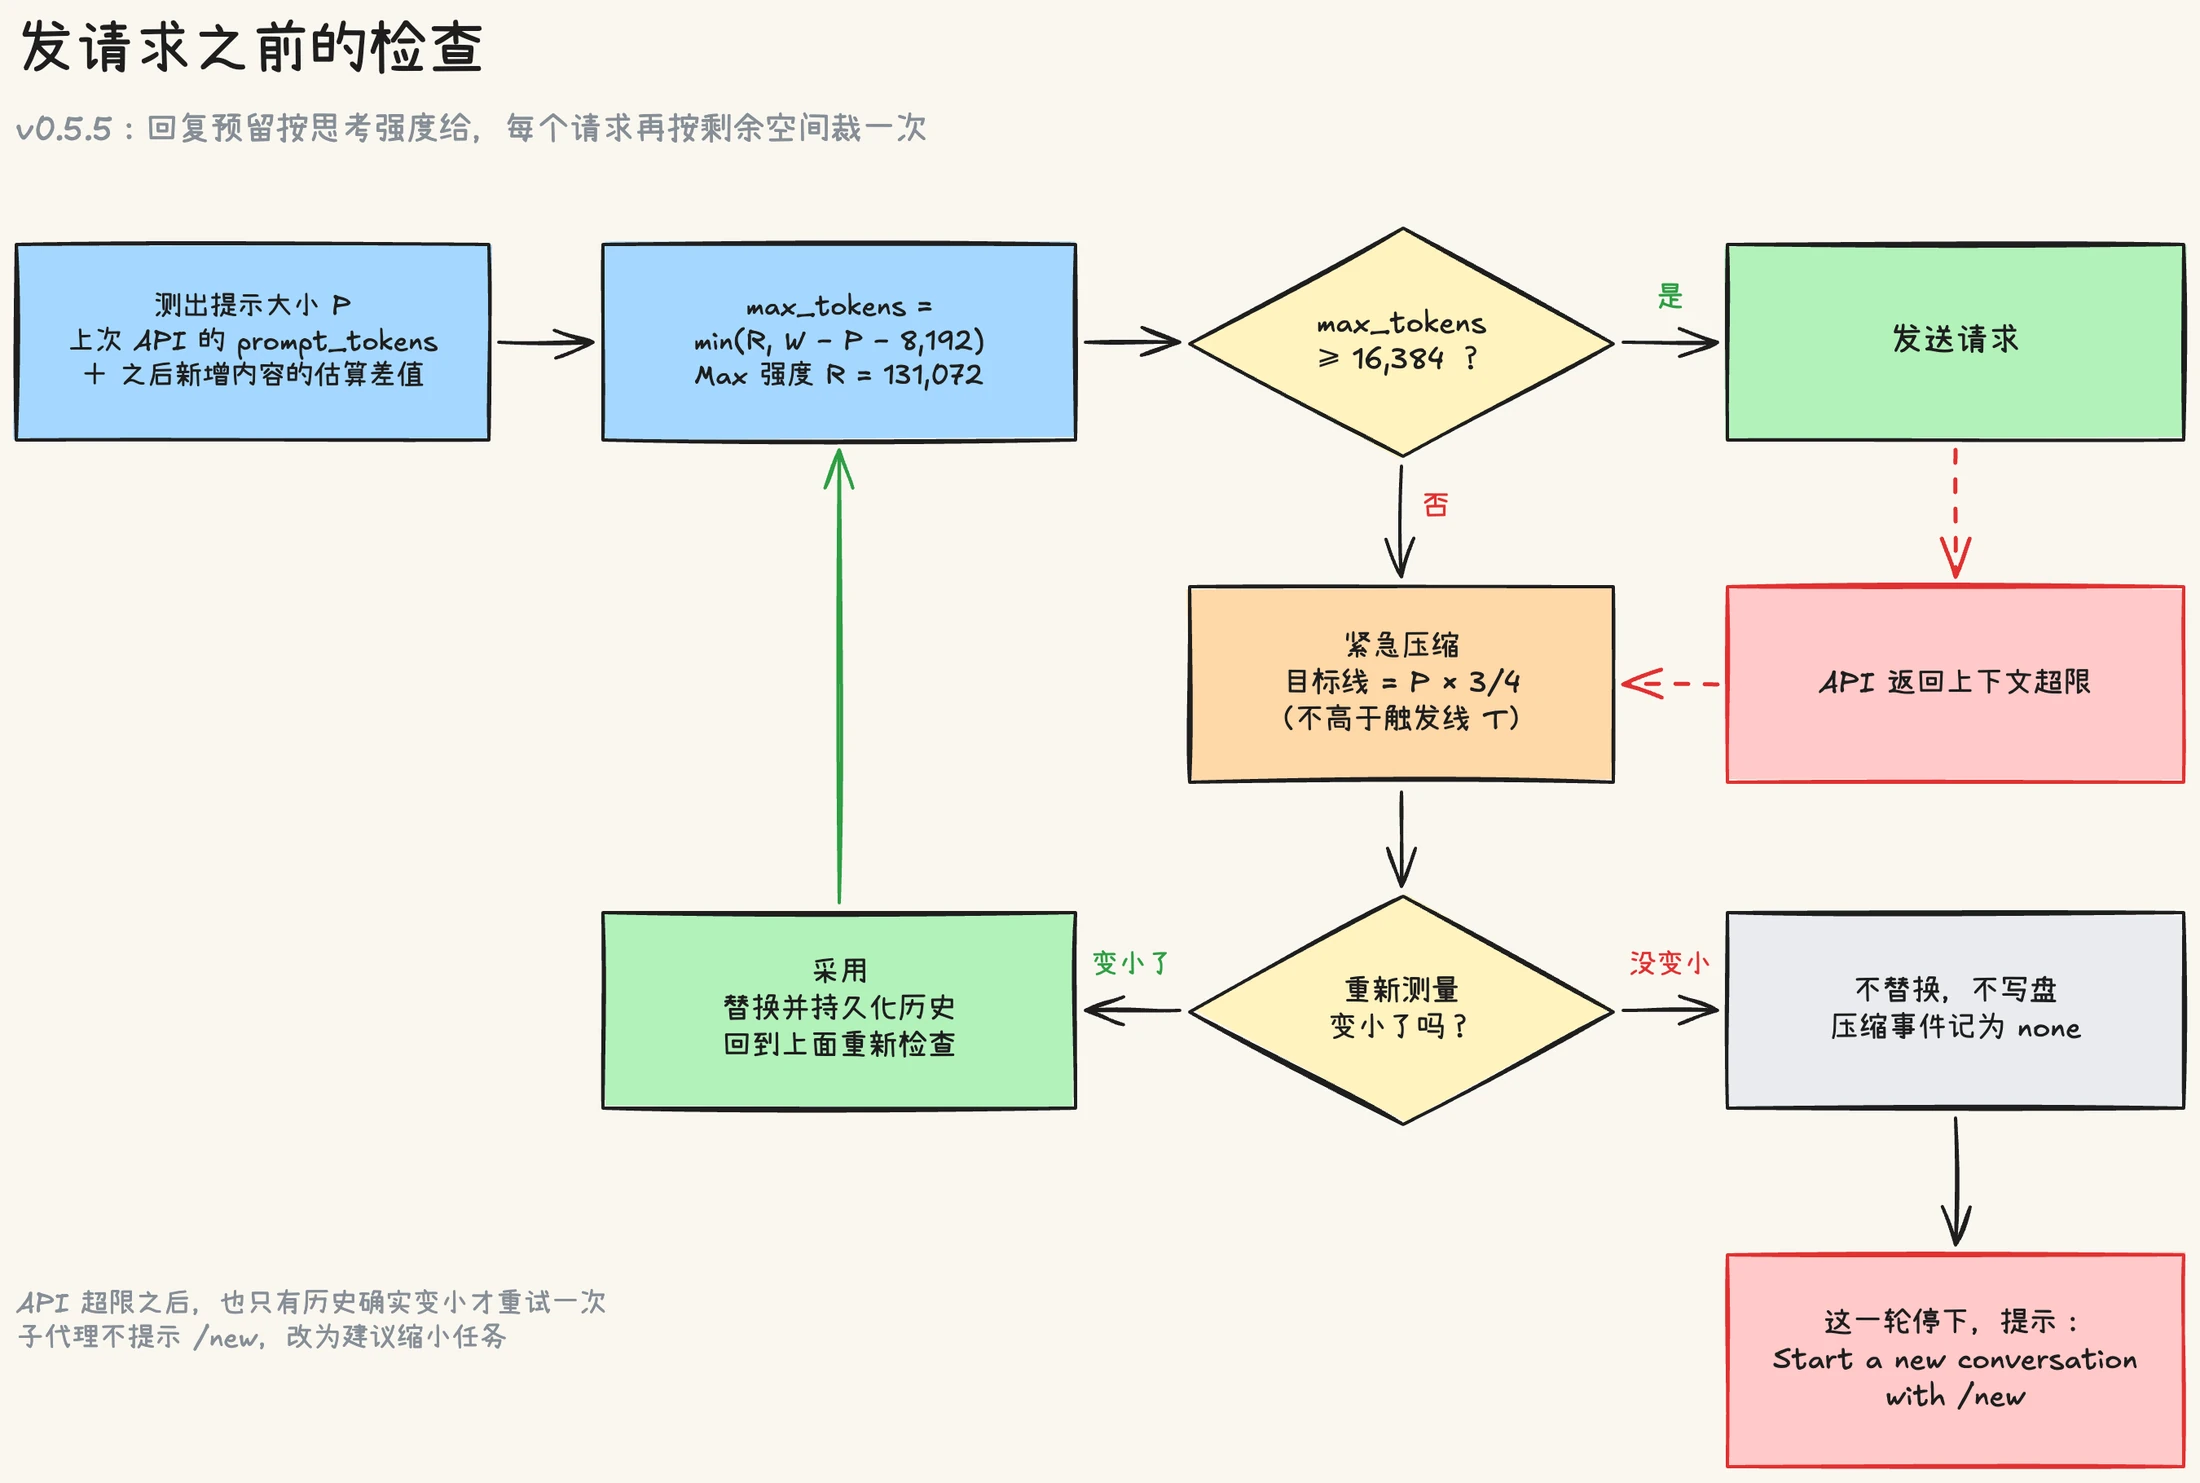
每次发请求之前,再按这一次的提示大小 P 把回复预留裁一次:
max_tokens = min(R, W − P − 8,192)裁完不少于 16,384 就照常发;少于 16,384,说明连最小的回复都放不下,先走紧急压缩。拿事故里的数字代进去,P = 664,935 时 max_tokens 是 131,072,合计 796,007,离上限还远。这组数字后来原样写进了单元测试。
P 本身的测法也换了锚。以前全靠本地的 cl100k 估算,现在以上一次请求 API 报告的 prompt_tokens 为准,再加上之后新增内容的估算差值。报告值和发送时的估算之比不在 0.5 到 1.6 之间时,这个锚不用:这样的计数多半合并了几次重试的用量,说明不了那一次请求。
仪表的分母也换成了 T。ctx N% 现在表示离自动压缩还剩多少,到 0% 意味着要压缩了,不再意味着请求要失败。/status 的写法是 N left before compaction (compacts at T)。同一个会话,新仪表上的数字会比以前低,仪表含义的变化写进了发版说明。
pinned 只保住它自己
压不动的问题分两层改。
第一层,任务完成通知、交给子代理的消息、wait 的结果和预算提醒,都改回普通 system 消息。它们是事件:模型看过一次之后,摘要可以代替原文。仍然 pinned 的只剩用户显式 pin 的上下文、plan 模式的切换说明这类很短的内容。旧会话恢复时,这几种通知自动解除 pin。
第二层,压缩的单位从轮换成单元。一条助手消息加上它所有工具调用的结果算一个单元,没有工具调用的助手消息自成一个单元,切分点只落在单元之间,工具调用和它的结果永远不拆开。pinned 的 system 或 user 消息只保住它自己,同一单元里的其余内容照常进摘要;pinned 的助手或工具消息保住整个单元,否则工具结果会丢掉它所回应的那次调用。
当前轮也可以切了。开启这一轮的用户消息始终保留原文,因为它是这一轮的任务说明;再从最新的单元往前累加,保留到 48K 的目标为止,最新的单元无论多大都保留;更早的部分进摘要。微压缩缩短旧工具输出时,同样跳过当前轮这段最近的内容,免得先把模型刚读过的输出剪掉。
压不动的时候要说出来
两种情况会进入紧急压缩:发请求前算出来装不下最小回复,或者 API 直接返回超限。紧急压缩把目标线压到 P 的四分之三(不高于 T),保证至少真正缩减一次。压完重新测量,变小了才采用,替换并持久化历史;没变小就不替换,也不写盘。
「变小才采用」后来扩到了所有压缩。之前一次压不动的普通压缩,会把原样的历史换回去、写进快照,再报告一次压缩完成,于是界面上会在 /new 的报错前面先出现一行 Compacted conversation context at token limit: N -> N messages。现在压不动的压缩事件照常结束(界面靠这个事件收起「正在压缩」的状态),只是策略记为 none,TUI 显示:
Context compaction could not shrink the conversation (N messages unchanged).然后这一轮停下,给出原因和下一步:
The conversation no longer fits the model's context window (about N tokens)
and compaction cannot shrink it further. Start a new conversation with /new.
API 超限之后的重试也一样:历史确实变小了才重试一次,没变小就不重试,在服务端的错误原文后面接上同样的建议。子代理用另一套措辞:父会话没有问题,所以不让人 /new,而是建议换一个更窄的任务重试。
同一份偏差,第一版扣了两次
实现里绕的一段弯路,和开头那三套口径是同一个病。
P 现在用的是 API 的计数,可压缩内部判断「够不够小」时,比的是本地估算,两者之间有一个比例。9 月 29 日晚上 9 点,紧急线先定成「API 计数和本地估算里较小那个的四分之三」。理由是当时的微压缩按原始估算剪:API 计数是估算的 1.5 倍时,按 API 口径画的线可能本来就在原始估算之上,于是什么也剪不掉。那时的测试里,一个 8 轮的历史只缩到估算的 0.88 倍就被采用了。
凌晨 0 点半,普通压缩也做了校准:压缩内部把估算按「API 计数 ÷ 估算」放大,只放大不缩小,两边总算在同一个口径上比较。可这样一来,紧急线再取「较小的那个」做底,API 多出来的那部分就被扣了两次:计数是估算的 1.5 倍时,紧急压缩剪了五段工具输出,其实剪到第三段就已经压到线下。凌晨 2 点 35 分,紧急线改回测量值 P 的四分之三,在两个口径上都是缩减四分之一。
还有一处也是口径问题。默认的 Max 强度下,软线和硬线重合在 768,928,于是每一次因为压力触发的普通压缩,都被当成越过硬线,走了紧急路径。最后单独加了一个 Overflow 触发:只有「装不下最小回复」和 API 超限才算紧急。
后来补的几个测试,都把「API 计数是估算的 1.5 倍」写成了用例的前提条件。
这次接受的代价
回复预留变小以后,Max 强度只给回复留 128K,极长的推理可能被截断,finish_reason 会是 length。需要时可以用 max_output_tokens 调大,逐请求的裁剪保证调大之后也不会再撞上限。
任务通知不再 pinned,压缩之后只以摘要的形式存在。压缩永远不会折叠当前单元,所以模型总会先看到通知的原文,再看到它的摘要。
当前轮可以被切开以后,同一轮里较早的工具输出会进摘要,细节可能丢一些。这只在越过触发线时发生。
一次工具输出就是 5 万 token
v0.5.5 做的是设计里的第一阶段,9 月 30 日发布。第二阶段要处理的问题,在这个事故会话里也有一个现成的例子:一次 task_list 返回了 189,075 个字符,大约 5 万 token,整段进了历史。
计划的做法是,工具结果写进历史之前先看大小,超过约 12,500 token 的完整写到会话目录下的文件里,模型只拿到开头、结尾和路径,再用 read_file 的 offset 和 limit 按需去读;task_list 默认只返回摘要字段,详情按任务 id 查。dsh 的 bash 工具处理长输出也是这个形状:截断,再在末尾附上完整输出落盘的路径。
这部分到现在还没有做。所以 v0.5.5 之后,ctx 的百分比说的是真话了,但一次工具调用往历史里塞进 5 万 token 这件事,现在还拦不住。
Keep Reading