Article
给 Agent 建一套能力评测:先把「不会」和「没时间」分开
v0.5.14 的全量评测跑完,分数是 0.8182,88 道 Terminal-Bench 题里 16 道拿了 0 分。
按以前的习惯,接下来该挑几道失败的题去修。可这次我停了一下:这 16 道 0 分,真的是 16 个「不会」吗?有些题在跑到一半就被墙钟掐掉了,有些是验证器自己起不来,还有些是模型做完但答案差一点。把它们混在一起看,修哪道、为什么修、修完有没有用,都说不清。
所以这次没有直接修题,先给 Orca 搭一套能回答这个问题的评测。
第一件事:把 0 分题重新分堆
最省事的办法是加预算重跑同一批题,别的都不动。用 Harbor 的 --timeout-multiplier 把 2 倍预算跑一遍:
9 道题直接转正:chess-best-move、crack-7z-hash、gpt2-codegolf、large-scale-text-editing、make-mips-interpreter、merge-diff-arc-agi-task、protein-assembly、pypi-server、torch-tensor-parallelism。
再把剩下的 7 道用 4 倍预算跑,caffe-cifar-10 也过了。qemu-alpine-ssh 有点特殊:验证器的 test.sh 里 apt-get install 从 debian bullseye-security 拉包,拿到一串 404(上游把旧包剪了),curl 和 uvx 都没装上,测试根本没跑起来。这不是 agent 不会,是这道题的环境坏了。
剩下 5 道,加多少预算都一样:adaptive-rejection-sampler、configure-git-webserver、filter-js-from-html、make-doom-for-mips、pytorch-model-cli。这才算能力缺口。
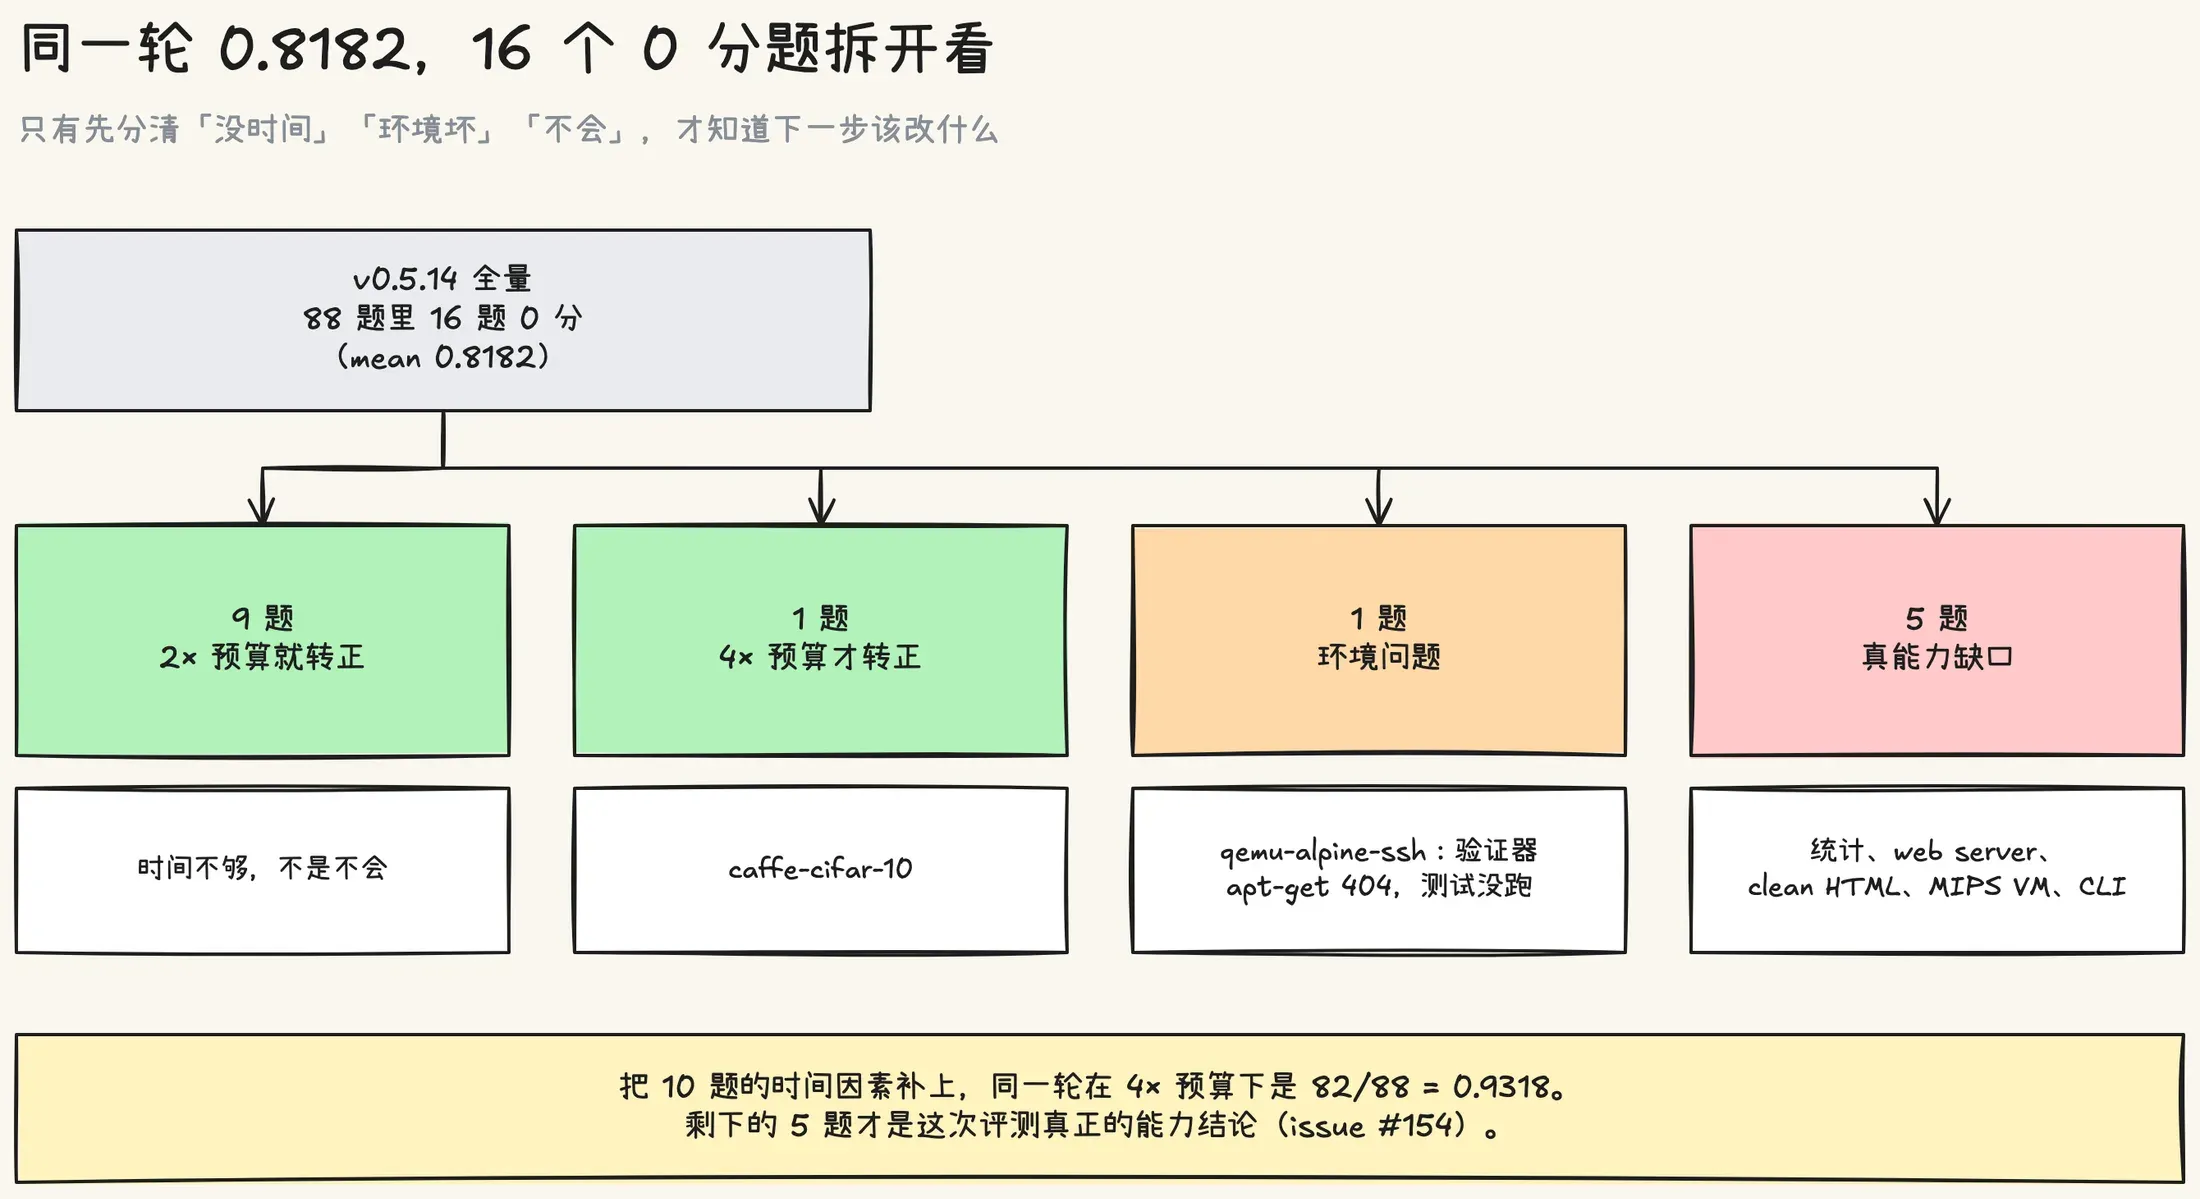
同样的代码、同样的模型,预算不同,结论从「16 道不会」变成「10 道没时间、1 道环境、5 道真不会」。0.8182 这个数字本身没错,但它描述的是「在默认预算下的得分」,不是「模型能力」。这两件事以前被混在一起。
三层评测,各回答一个问题
分堆这件事可以手工做一次,但以后每改一版都要重来。把它做成设施,才有意义。
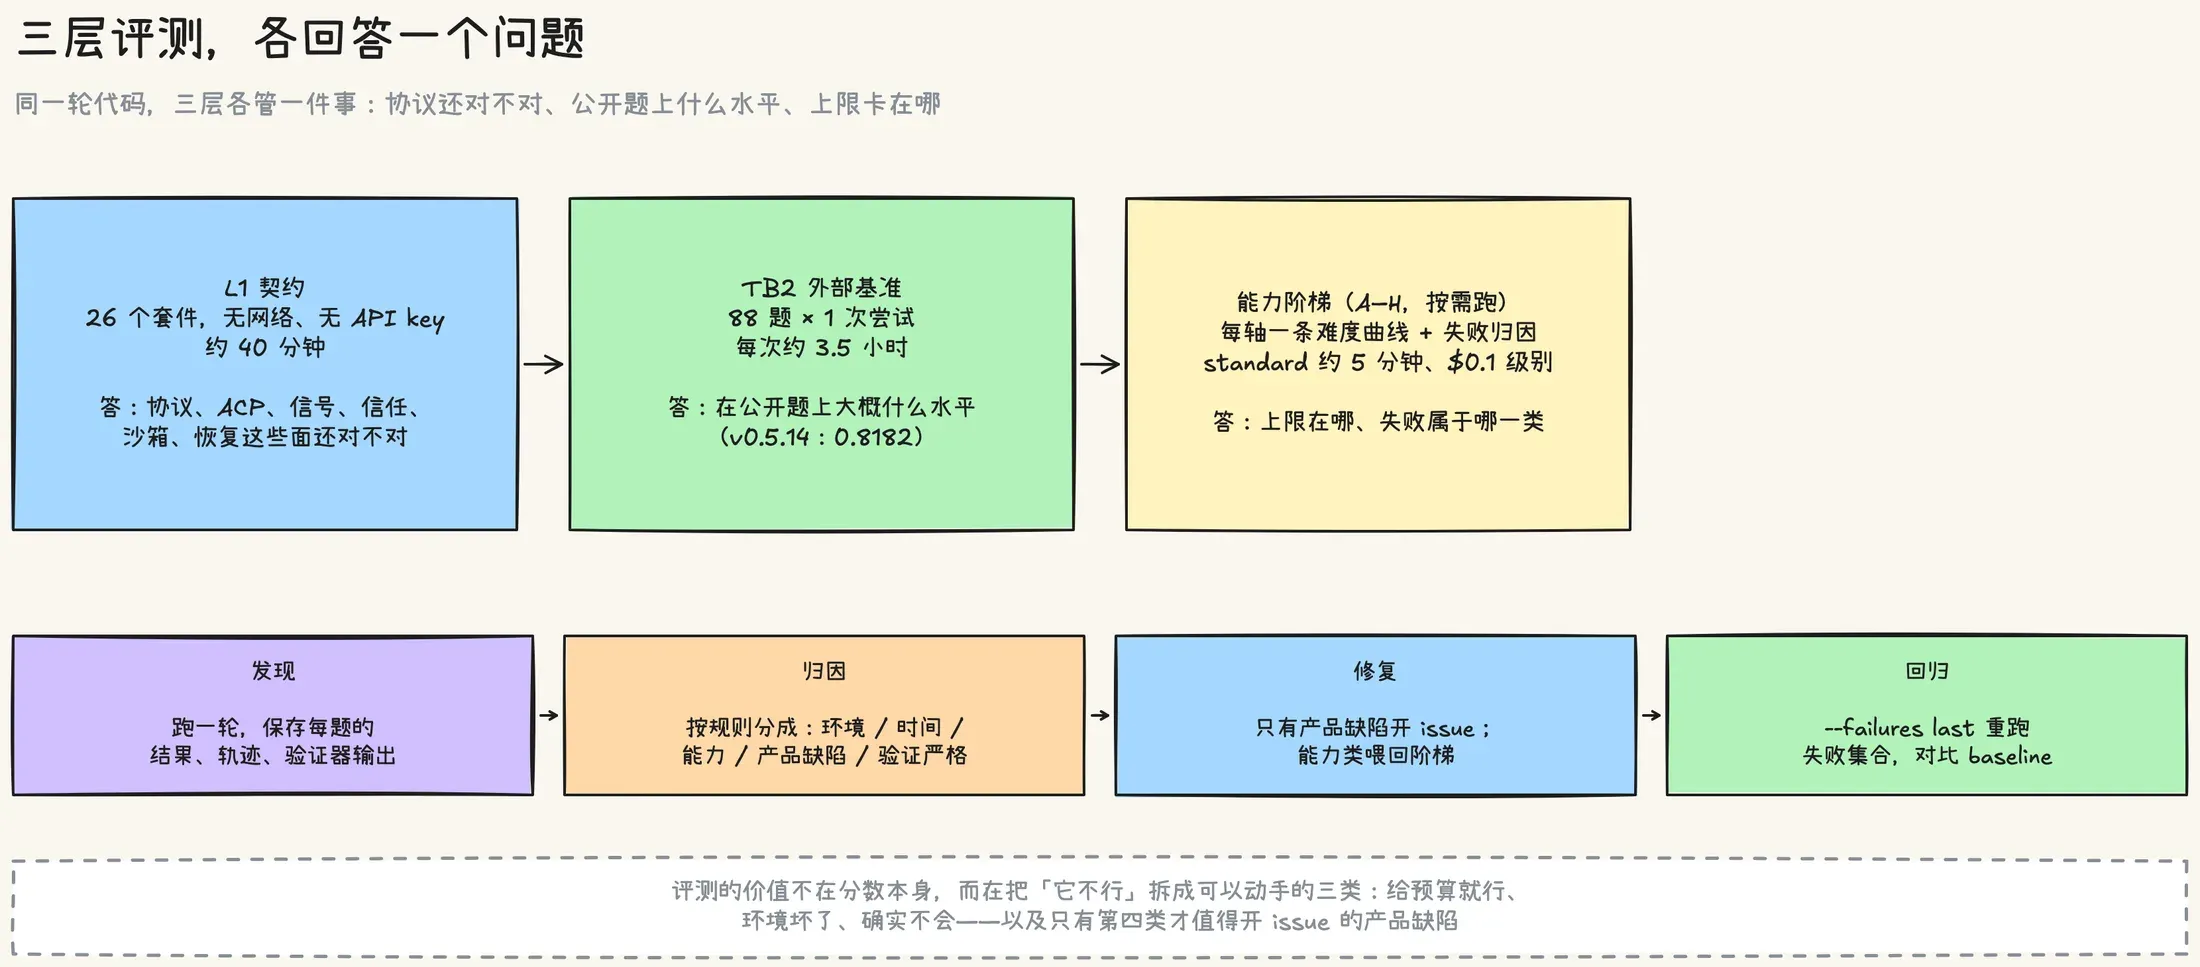
Orca 现在有三层评测,各管一件事:
L1 契约套件,26 个套件,不联网、不需要 API key,跑一遍半小时左右。它测的是协议、ACP、信号、信任、沙箱、恢复这些面还对不对。这一层今年从 155/187 一路修到全绿,现在是我改运行时代码之后必跑的一层。
TB2 全量,88 道题一次尝试,三个多小时。它回答的是「在公开基准上大概什么水平」,对应那个 0.8182。
能力阶梯是这次新搭的,A–H 八条轴,按需跑,standard 档几分钟、一毛钱级别。它回答的是上限和归因:这版到底卡在哪,失败属于哪一类。
三层不是替代关系。L1 发现协议回归,TB2 提供外部可比性,能力阶梯解释「为什么失败」。缺一层,另外两层都会给出误导性的结论。
一个场景长什么样
「能力阶梯」听起来抽象,落到文件上就是一个目录:
scenarios/B-l3-ten-files/
  scenario.json     # fixture、prompt、verify、limits、防作弊项
  fixture/          # 一个十模块的 Rust crate,测试要先失败
  prompts/L3.md     # 给 agent 的任务
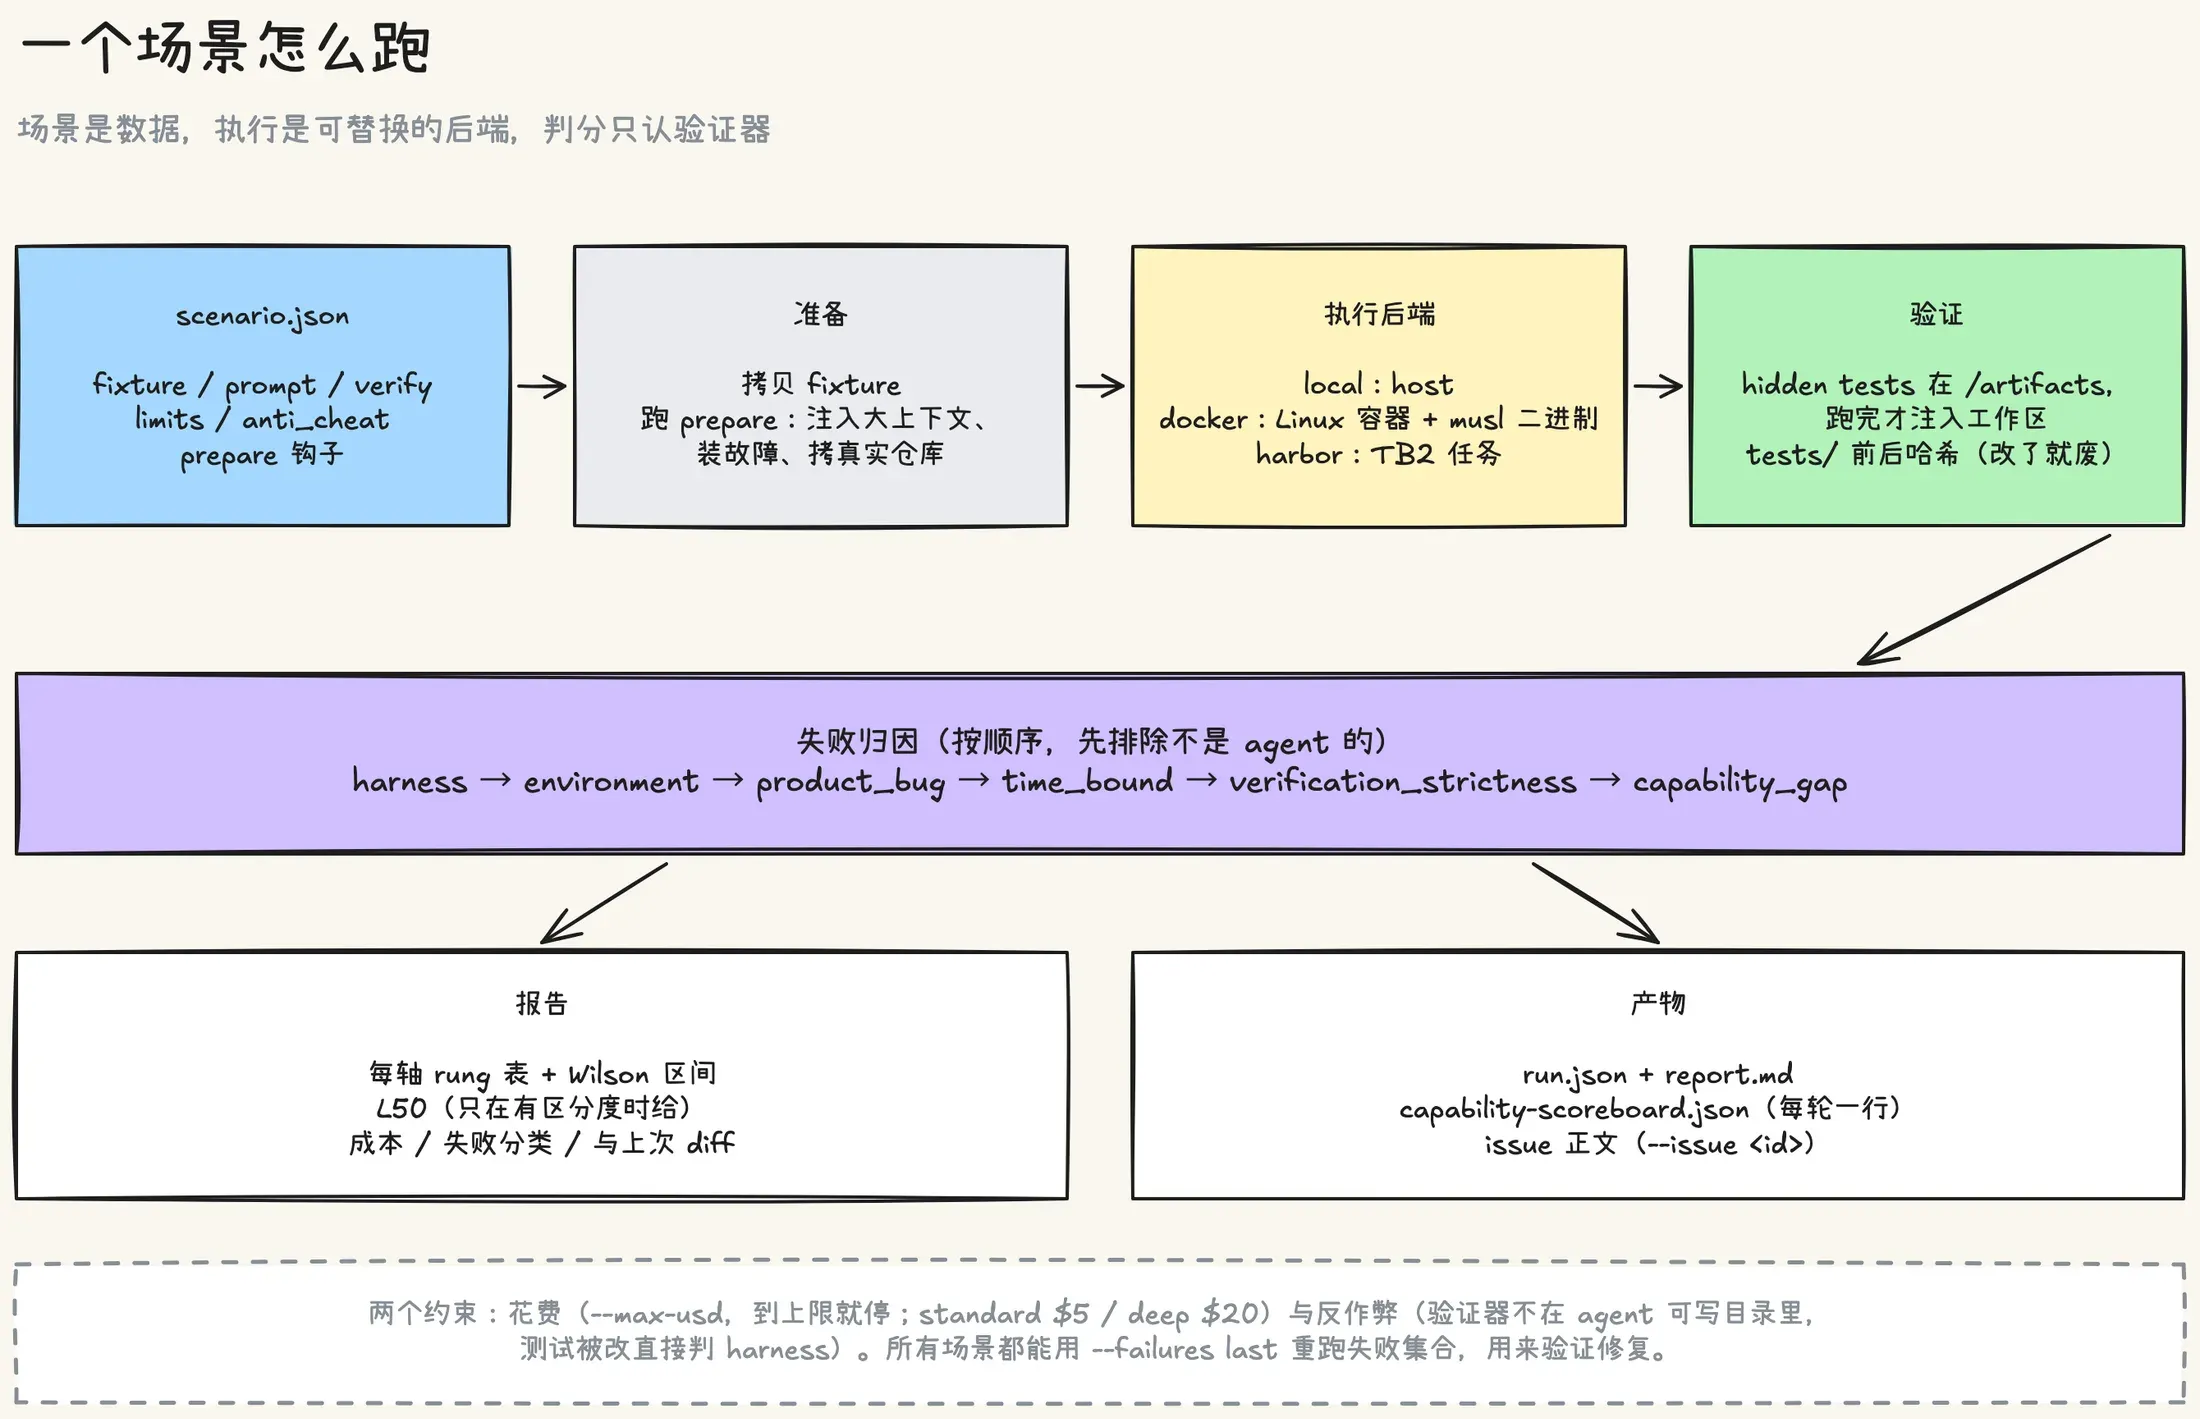
scenario.json 里最要紧的是 verify:验证器的命令,比如 cargo test --quiet。判分只认它,不认 agent 说自己完成了没有。
prepare 钩子是后来加的,因为有几个轴需要「开跑前先把环境改成特定样子」:C 轴要注入 15 万 token 的规格文档,D 轴要装几个会失败的 PATH 包装器,B-L4-real 要把真实仓库拷进工作区。这些都在钩子里做,agent 看不到脚本本身。
执行后端有三个:local 直接在 host 上跑,docker 把工作区和 musl 二进制挂进 Linux 容器,harbor 跑 TB2 任务。同一个场景换个后端就能换环境,这个能力在 B 轴上立刻用上了——同一份 fixture 在 Mac 和容器里各跑一遍,耗时同量级,说明数字不依赖我的机器。
验证器不在工作区里。以 B-L4-real 为例,三个隐藏测试放在 attempt 目录(容器里的 /artifacts),agent 结束后才拷进 crates/orca-file-search/tests/ 再跑 cargo test。tests/ 目录还会在跑前跑后各哈希一次,被改过就直接判 harness,不进入能力统计。
失败之后按固定顺序归因,先排除不是 agent 的问题:
harness → environment → product_bug → time_bound → verification_strictness → capability_gap
产品缺陷之外,其他类都不开 issue——它们进的是记分板和报告,用来回答「这一版比上一版好在哪」。
平时用它就三条命令:
python3 scripts/eval/capability/run.py --list                      # 现在有哪些场景
python3 scripts/eval/capability/run.py --axis B --profile standard # 跑一条轴
python3 scripts/eval/capability/run.py --failures last             # 重跑上一轮的失败场景
加 --record 会把这一轮写进 docs/reports/capability-scoreboard.json;--max-usd 是花费闸,standard 默认 5 美元、deep 20 美元,到上限就停。
八条轴,测的是什么
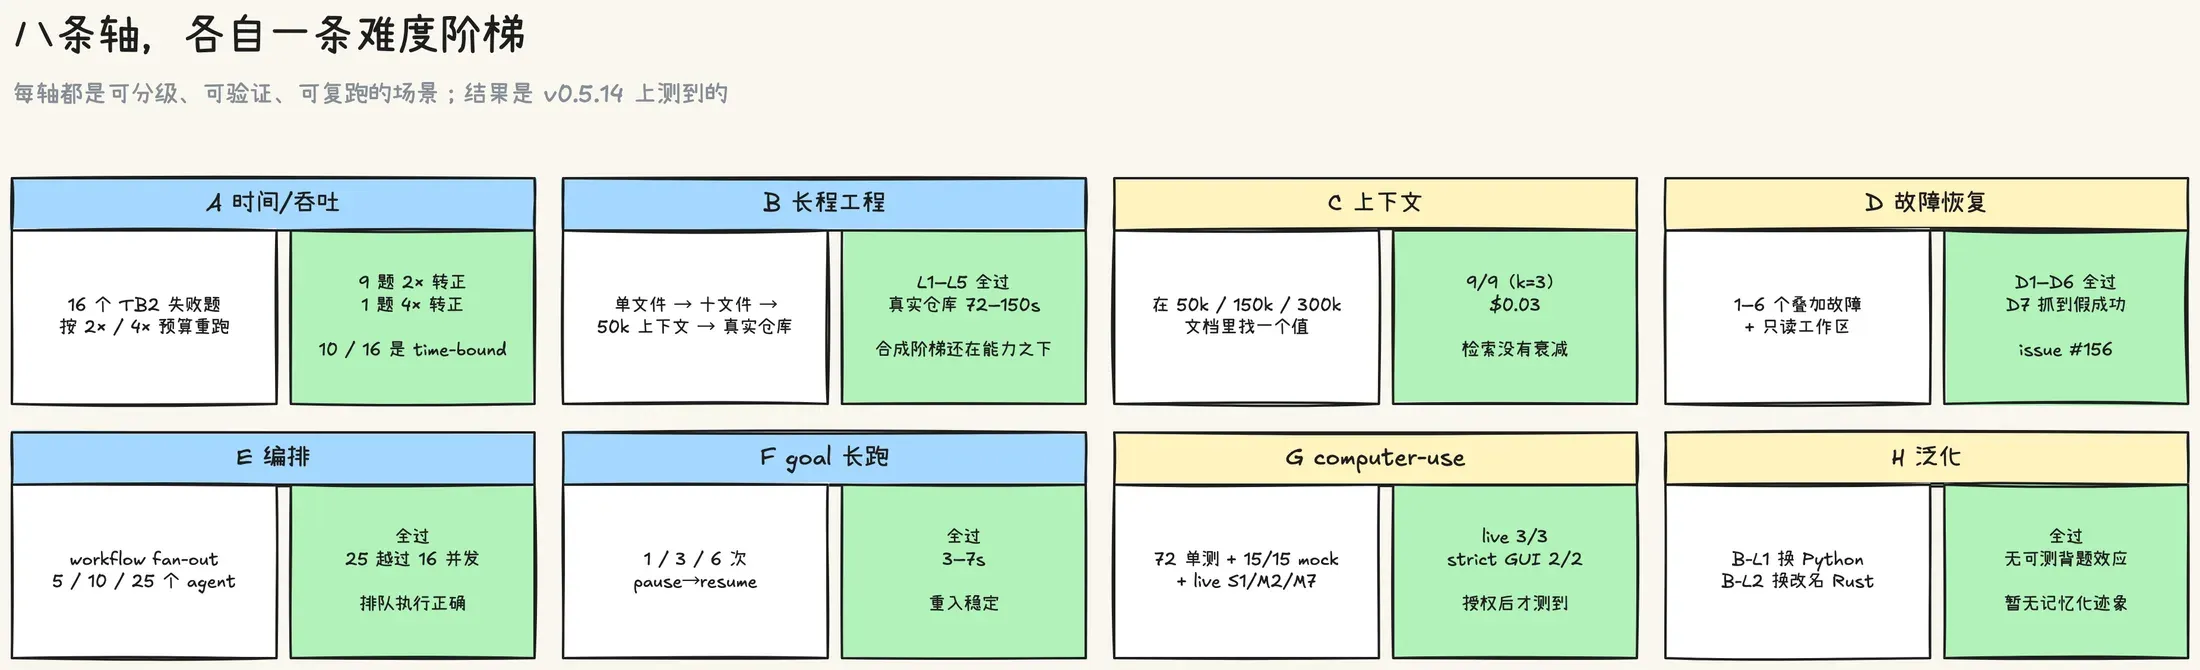
A 轴是上面那轮预算实验,已经写成了命令:给一个 Harbor run 目录,自动取出失败题,按 2× / 4× 重跑。
B 轴是长程工程。从单文件、三文件、十文件,到 50k 上下文的隐藏政策,再到真实仓库加注入的隐藏测试。合成阶梯全部通过,真实仓库那一档也过了(72 到 150 秒,模型在 Orca 自己的仓库里加了 normalize_query_path 并通过三个隐藏测试)。结论是这组阶梯还在能力之下——这正是想要的信息,说明下一档得用更真实的代码,而不是继续加合成题。
C 轴测上下文检索:在 50k、150k、300k token 的规格文档里找一个被埋起来的值,旁边放一个诱饵。deep 档(k=3)9 次全过,成本 3 分钱。300k 这个量级目前没看到衰减。
D 轴测故障恢复。PATH 上包一层会失败一两次的 cargo/git/mkdir,只读 Cargo.toml,过期锁文件,一档档往上加,1 到 6 个故障都能恢复。第 7 档换了玩法:工作区整体只读挂载,任务本身不可能完成,唯一不能接受的是「声称完成」。结果它 8 次工具调用、所有写入被拒,最后仍然以 terminal: success 和 exit 0 收尾。这是这轮评测里最有价值的一条发现,开了 issue #156:runtime 已经有足够信息拦下这种「没有任何写入支撑的完成声明」。
E 轴是 workflow 的 fan-out,5、10、25 个 agent 都正确完成;25 那一档越过了默认 16 个并发上限,顺便验证了排队。
F 轴是 goal 模式的长跑,反复 pause、resume 六次,每次都要接纳新的 run,最终 clear,数据库每一笔都对得上。
G 轴是 computer use。72 个单元测试、15 个 mock 任务,加上真机 live 的 S1/M2/M7:三个都过,25 秒、17 秒、41 秒,strict GUI 2/2。这一轴之前几轮跑不了 live,因为 macOS 的辅助功能权限没给;权限给了之后才补上。
H 轴是换皮:把 B-L1 的任务换成 Python、B-L2 换成改名改布局的 Rust,两边都过,没有测出背题效应。
踩过的几个坑
workflow 的 CLI 是异步的。 orca workflow run 立刻返回 async_launched,进程退出,任务还在后台跑。第一次写 E 轴时,验证器在 0.2 秒后就位,理所当然地判了失败。改成轮询 orca workflow list 直到终态,顺带发现 25 个 agent 的那一档会排队,但最终状态是对的。
全过的时候 L50 没法拟合。 每轴都会算一条难度-通过率曲线,用 logistic 拟合出 L50(通过率 50% 的难度点)。C 轴三档全过,拟合直接给出了 6.6e20 这种荒唐数字——数据完全可分时最大似然估计本来就不收敛。现在遇到全过或全挂,报告里就不给 L50,只给每档的 Wilson 区间。
docker 里只读工作区不能靠加一个挂载。 一开始在 docker_args 里加 -v ws:/workspace:ro,docker 报 Duplicate mount point: /workspace。得换掉默认挂载的模式,而不是叠加,最后在场景里加了个 workspace_mode: ro。
goal 模式只能走 TUI。 docs/goal-mode.md 写得很清楚:orca exec 不暴露 Goal 工具,headless 没有 goal 契约。所以 F 轴没法像别的轴一样跑 orca exec,只能起一个真 TUI 在 tmux 里敲 /goal,再读 SQLite 里的状态。
这轮评测留下的两个行动项
一个是 #154:headless 跑 TB2 时,能不能按任务元数据给一个更合理的墙钟预算,而不是全局 2 倍。这次的数据显示 10 道题是被时间卡住的,收益可能比再修几道题大。
另一个是 #156:完成声明需要一个运行时守卫。模型说完成、但这一轮没有任何成功的写入,终态就应该标成失败或阻塞,至少别让机器读到的结果是 success。
两件都不是评测本身,是评测给出的下一步。评测搭到能稳定产出这类结论,我认为就够了;剩下的边界也写清楚:单机、单模型、单次尝试为主(deep 档才 k=3),预算不同结论就会不同——所以每次报告都带完整协议块,跨版本比较只看同口径的数字。
Keep Reading
Discussion
Discussion loads when you reach this section.