Article
截图里明明有字,OCR 为什么返回空?
Clipnest 是我做的剪贴板历史工具。复制过的文字可以搜索,截图却只能一张张翻。我想让搜索框也能找到截图里的报错、函数名和文件路径。
macOS 自带 Vision,能在本机识别图片文字,不需要把截图传出去。接上 VNRecognizeTextRequest,小截图里的中英文和代码都能出来。换成 5K、6K 的整屏截图,结果突然变成空的:没有报错,一行字也没有。
把图切小以后,字找回来了。接着又遇到两个问题:一张长截图识别要 28 秒;给图片补写几行文字,数据库竟然连图片内容也要重写。
配图可以点开查看高清原图。
先按搜索来评测
代码里一个字符认错,就可能让搜索失效。config.yaml 被认成 config-yaml,人看一眼还能猜出来,按原文件名搜索却找不到。大段正文都认对,也抵消不了这一个错误。
所以评测同时看两个数。一个是搜索词召回率:预先选好可能会搜的词,检查它们有没有出现在识别文字中,匹配规则沿用应用的大小写不敏感子串匹配。另一个是 CER,也就是字符错误率:把输出变成原文需要增、删、改多少个字符,再除以原文长度。本轮 CER 会去掉空白,因此它看不出多插了一个空格是否破坏了函数名,搜索词那项正好补上。
语料先从 13 张小截图开始,共 71 个搜索词,包含中文界面、中英混排、繁体、Go、TypeScript、JSON、终端报错和链接。同一份语料,各组配置分别跑三轮,输出一致。
| 配置 | 命中的搜索词 | 召回率 |
|---|---|---|
| 自动检测语言,关闭语言校正 | 68 / 71 | 95.8% |
| 自动检测语言,开启语言校正 | 67 / 71 | 94.4% |
| 指定中英文,开启语言校正 | 58 / 71 | 81.7% |
| 自动检测与指定中英文各识别一次,再合并 | 69 / 71 | 97.2% |
开启和关闭语言校正,平均 CER 都是 0.023,搜索词命中数却不同。校正会把 tx.Commit() 拆成 tx. Commit(),把 config.yaml 拆成 config. yaml。这个选项对自然语言有它的用途,放到代码截图上却会改坏搜索词。自动检测语言、关闭校正,成了最后采用的配置。
两次识别能多命中 1 个词,耗时约为两倍。71 个词里,1 个词就能让百分比涨约 1.4 个百分点。把分子和分母写出来,这个收益就没那么诱人了。
还有 16 张不含文字的照片,用来检查会不会凭空认出字。本轮全部返回空。对剪贴板来说,这项也得测:照片里冒出一串错误文字,会影响标题和搜索结果。
这些指标随用途而变。如果做的是票据录入,就应该检查金额、日期和单号;如果做的是文章扫描,段落顺序和正文完整性会更重要。Clipnest 要找回截图,就先看用户会搜的那几个词。总体字符错误率低,不能替代这一步。
小字为什么在大图里消失
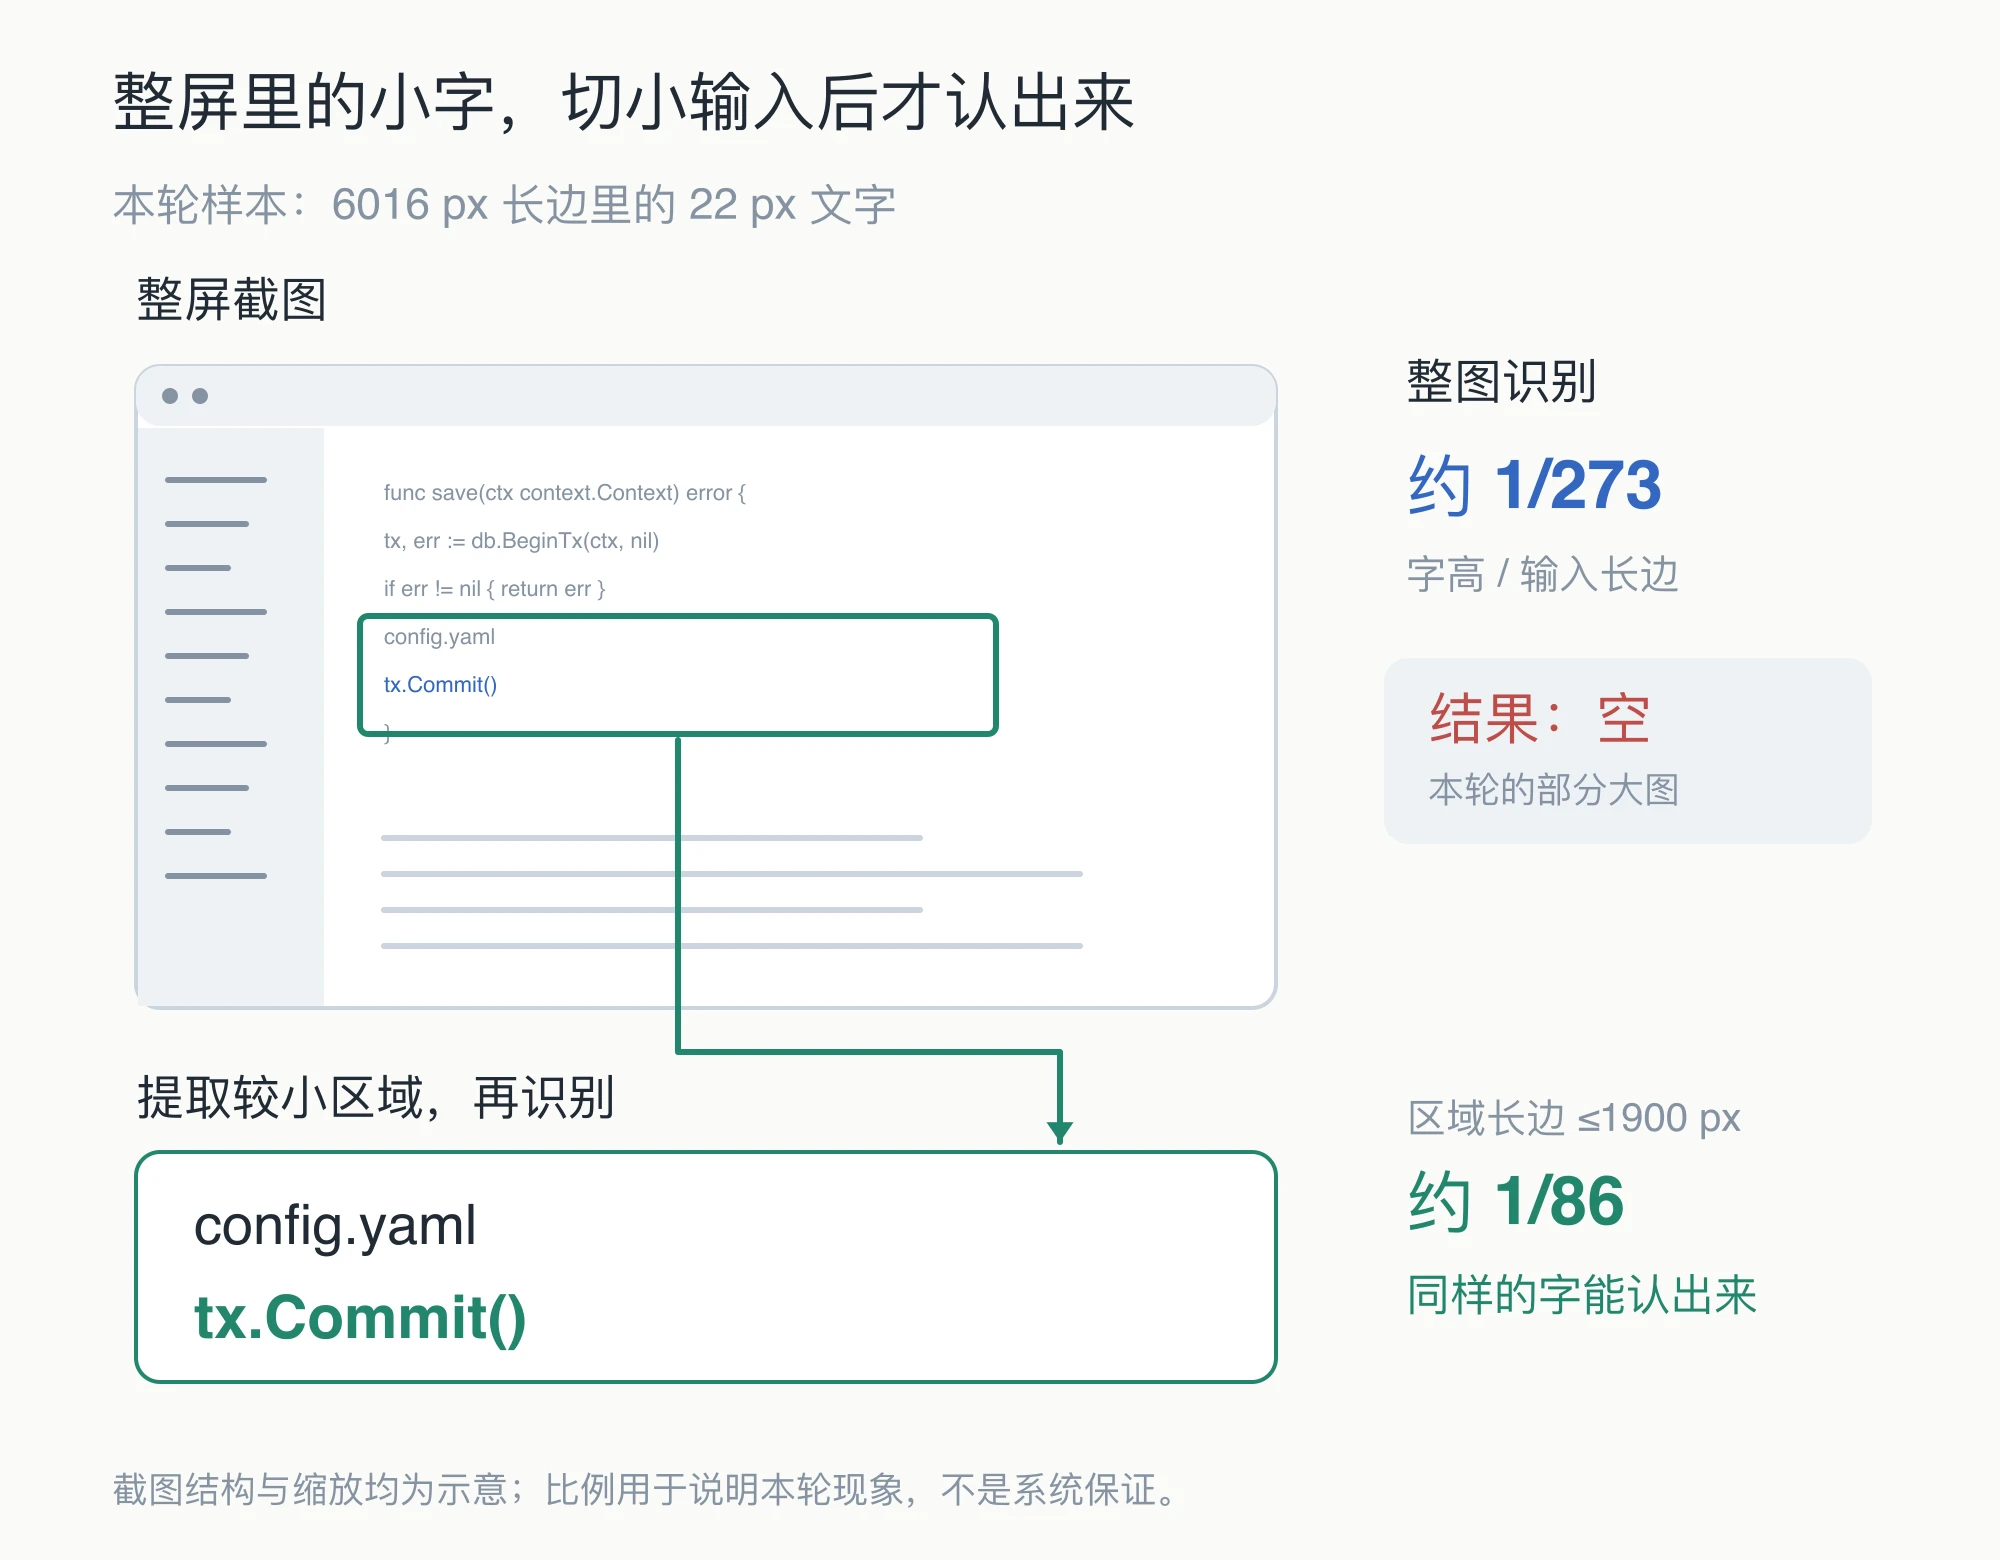
在本轮测试里,文字高度低于图片长边约 1/180 时,整图识别会漏字,有些图直接返回空。6016 px 宽的截图里,22 px 高的小字只占长边的约 1/273,正好属于容易出问题的那一类。
这里的 1/180 是测试中观察到的规律,不是 Vision 文档给出的保证。它足够指导这次修复,还不能外推到所有字体和系统版本。
调小 minimumTextHeight、换旧版识别模型,都没有解决问题。切成较小的区域以后,同样的字能被认出来。比如长边缩到 1900 px,22 px 的字占比就变成约 1/86。图片里的字没变大,它在一次识别输入中占的比例变大了。
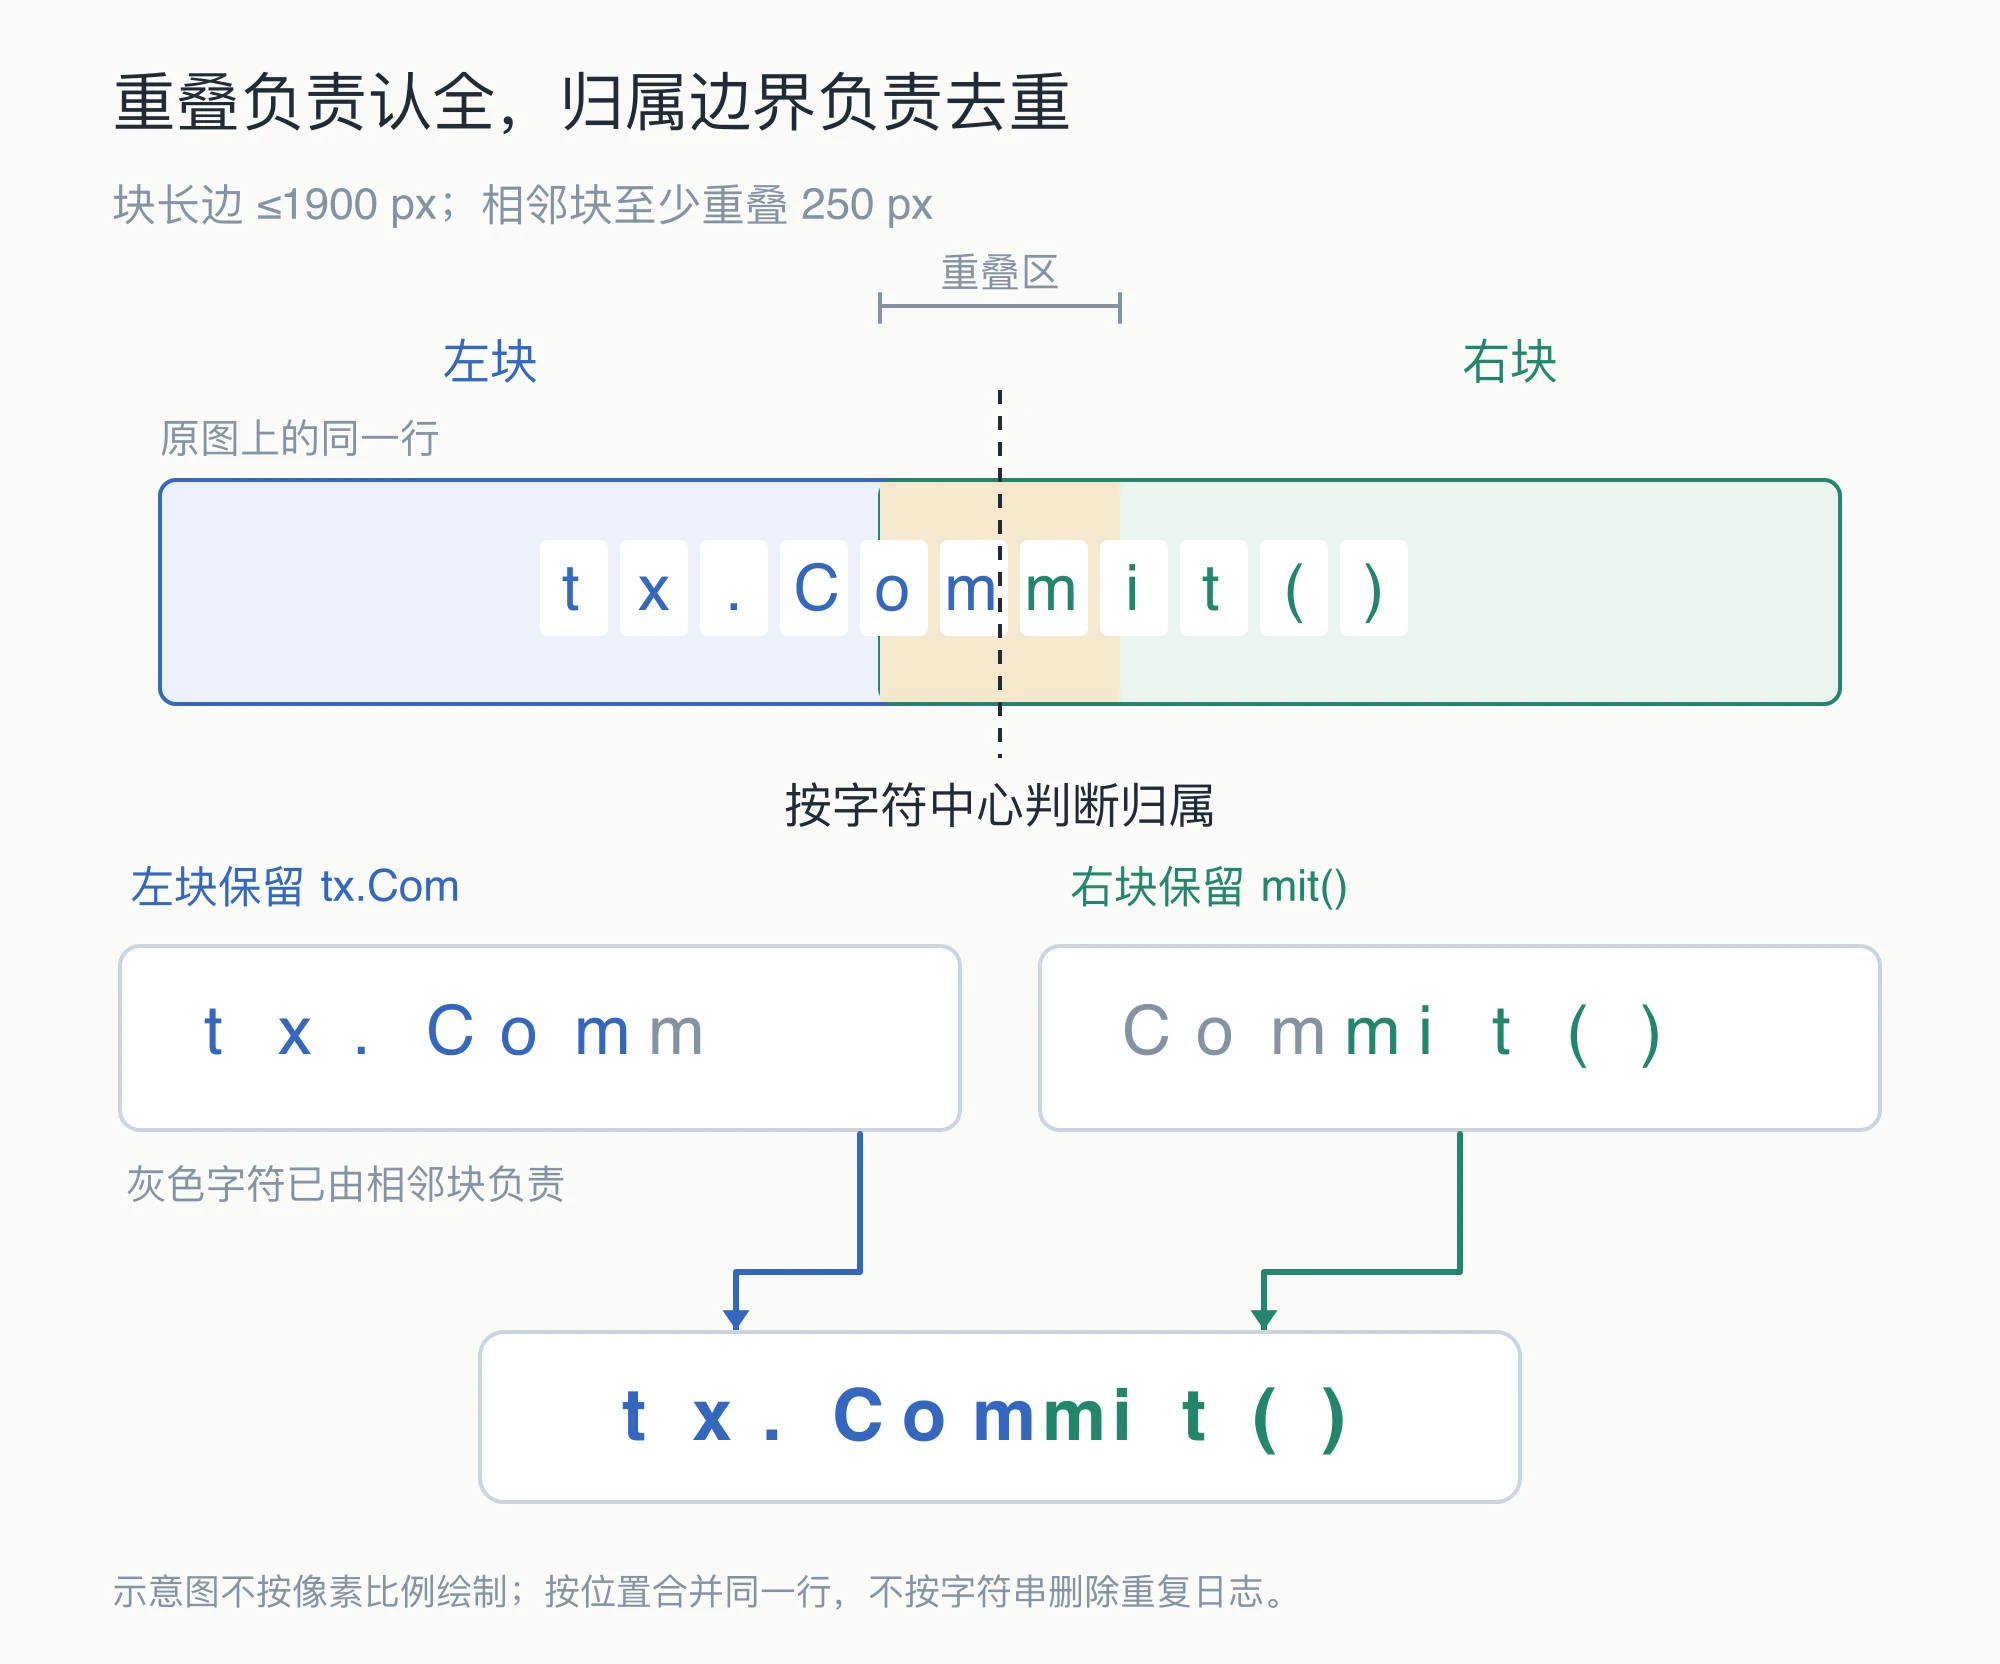
采用的规则是长边超过 1900 px 就分块,每块长边不超过 1900 px,相邻块至少重叠 250 px。这几个数来自这一轮语料和测试,不是通用的 OCR 最优参数。
重叠不能省。直接切开,边缘可能刚好落在一个字中间;加了重叠,同一行又可能出现两遍。实现里把重叠区的中线作为归属边界,每块保留自己负责的文字,跨左右边界的行再按字符位置拼起来。
也不能简单按字符串去重。终端里本来就可能有两行相同的日志,删掉其中一行会损失原文。空间位置能区分「同一行被认了两次」和「原图上确实有两行」。
这次之后,我给语料补了整屏截图和长截图。只测裁好的小图,会把输入尺寸带来的问题整个漏掉。测试样本除了覆盖内容,还得覆盖应用实际收到的尺寸、文字密度和边界位置。
准确率最高的方案,慢了八倍
Vision 有一个 regionOfInterest 参数,可以指定识别区域,图片仍然整张传入。它在 7 张整屏截图、121 个搜索词上命中 119 个,召回率 98.3%。Go 先解码整图、把每块编码成独立 PNG 再识别,命中 117 个,召回率 96.7%。
只看这两个数,会选 Vision 原生参数。
再单独测一张 2880×16000 的长截图,区域参数那条路要约 28 秒,Go 解码一次的方式约 3–3.5 秒。前者在当时的调用方式下,每个区域都重新解码整张图片;分块越多,这份重复工作越贵。后者虽然多了一步 PNG 编码,但整图只解码一次。
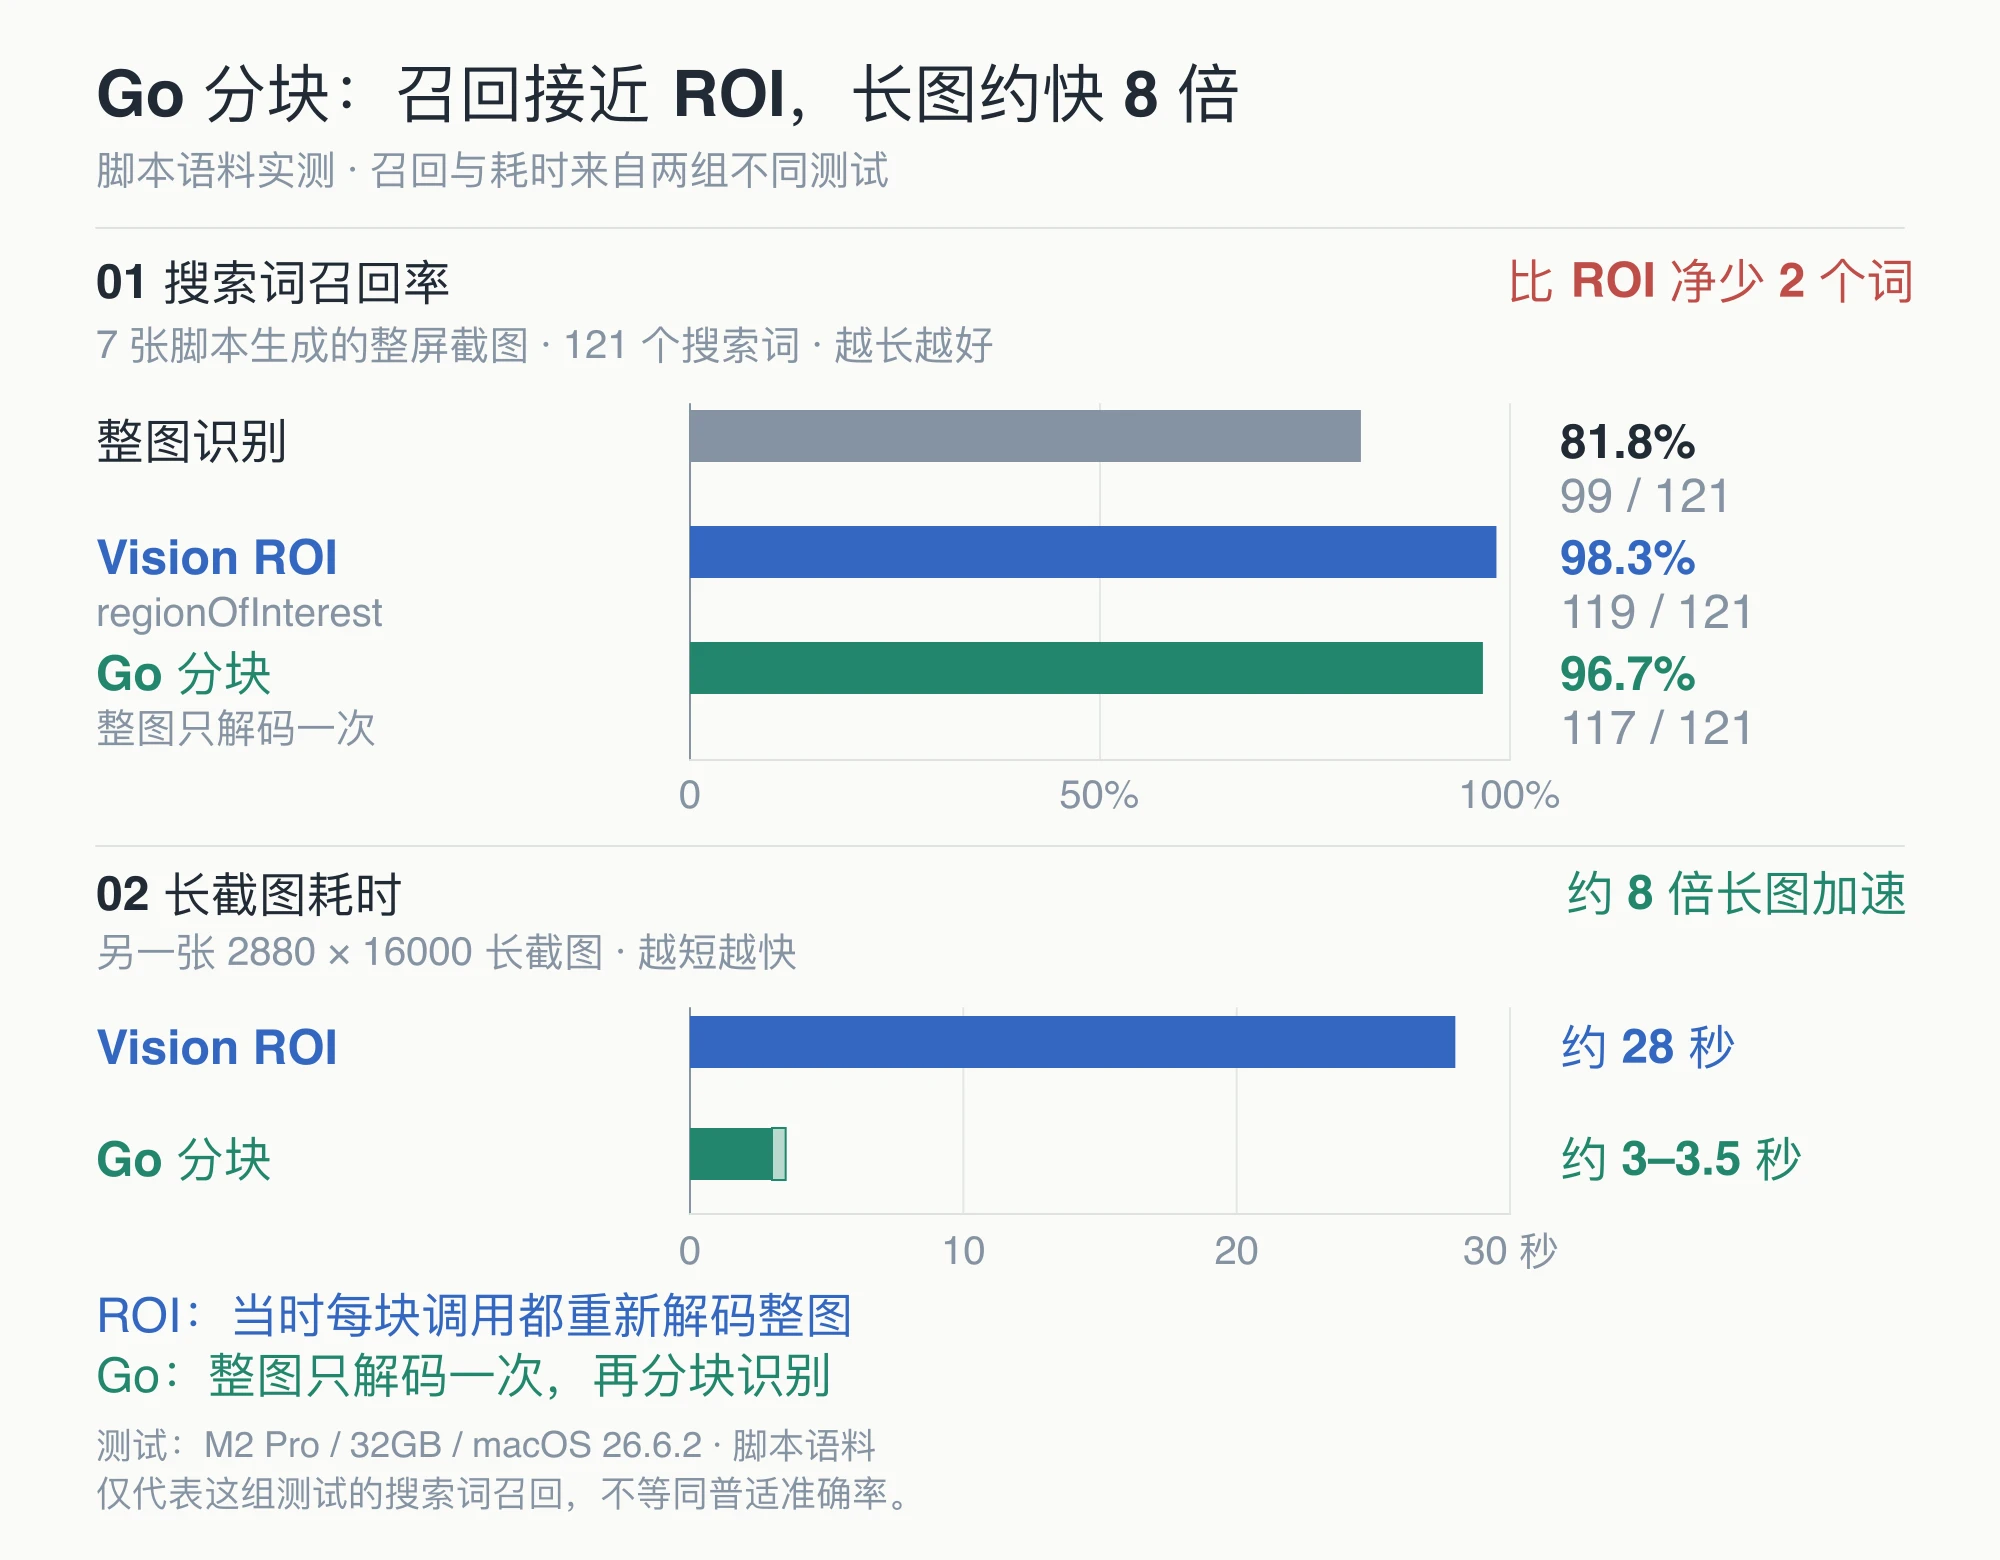
图里的召回率来自整屏截图语料,28 秒与 3–3.5 秒来自那张长截图的单独对比。它们回答两个问题:一般截图能找回多少词,遇到很长的图会等多久。
决定之前还要看漏了什么。采用方案的 4 个漏词里,有 tx.Commit() 变成 tx.Commıt()、config.yaml 变成 config-yaml 这样的逐字错误。更高分的方案也有自己的漏词,两边并不是谁的结果完全包含谁的。
我最后保留了解码一次的方式。剪贴板会连续收到图片,单张卡住几十秒,会让后面的任务一起等。两词的净收益,不足以接受这个耗时。
如果漏掉的是金额、单号,或者一整块正文,这个判断就要重做。百分比相近,不代表错误的代价相近。选型时保留每个方案的漏词清单,比只存一张总分表有用。
一张图片要用多少内存
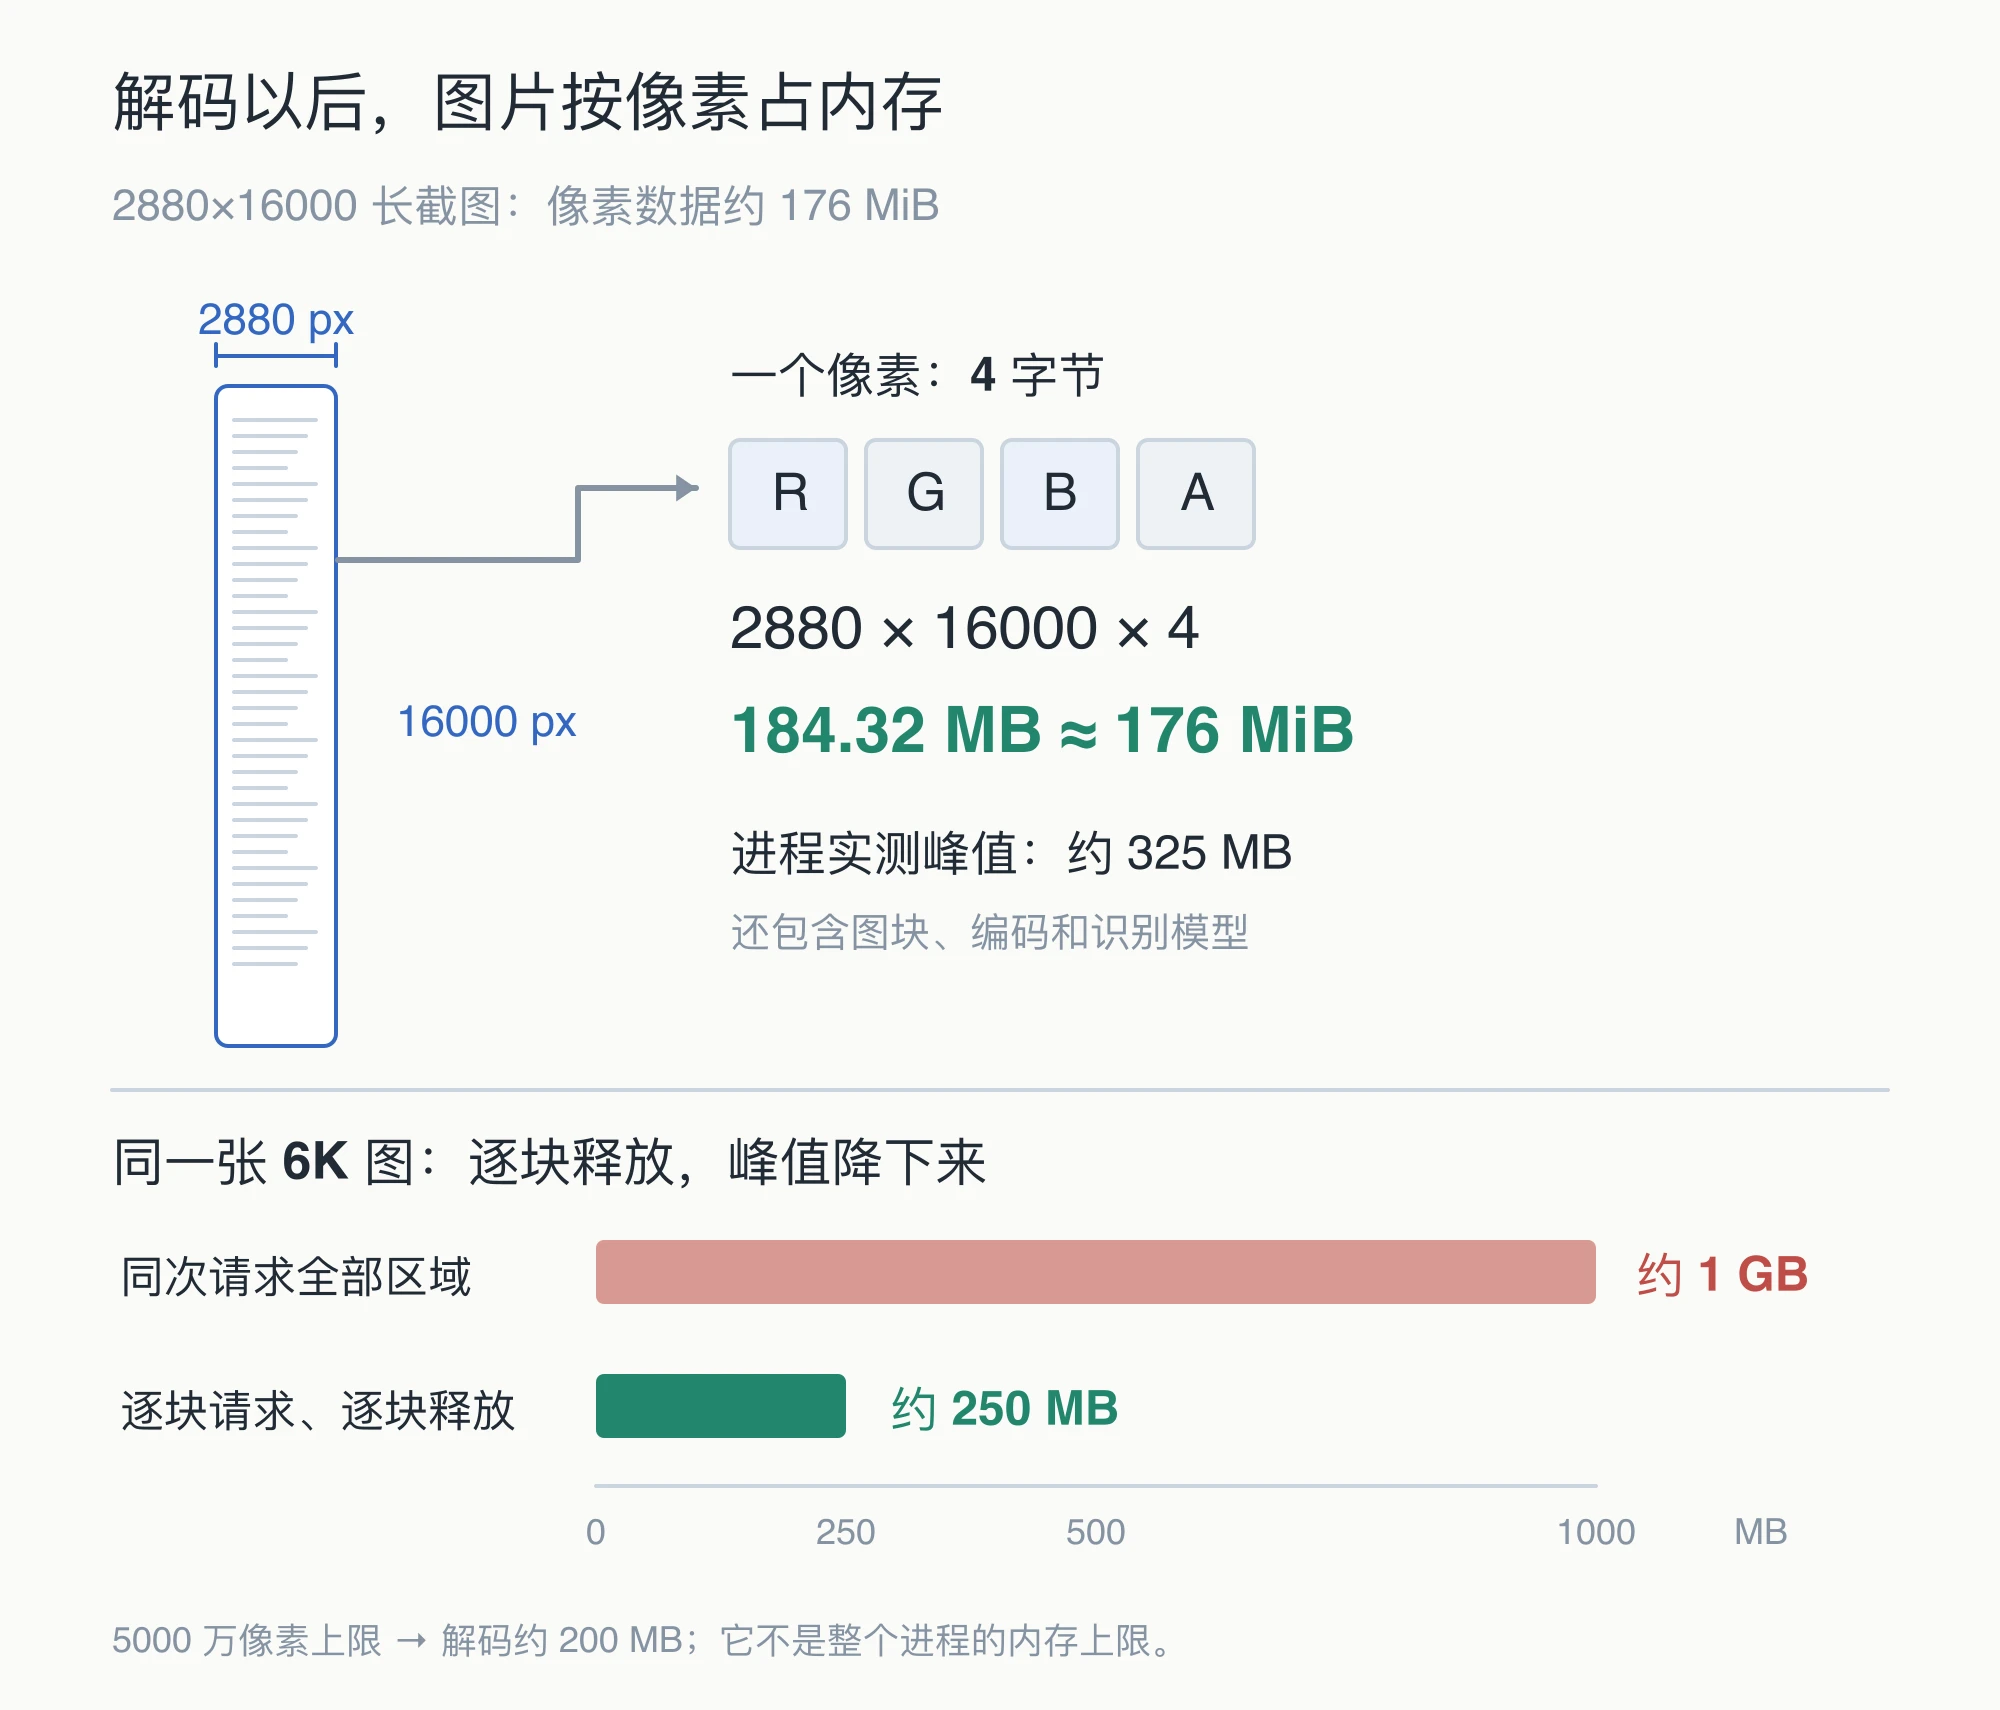
一张 PNG 在磁盘上很小,解码以后也可能很大。这里使用的位图每像素 4 字节,那张 2880×16000 的长截图,仅像素数据就要:
2880 × 16000 × 4 = 184,320,000 字节 ≈ 176 MiB
这还没算分块、编码和识别模型。用 /usr/bin/time -l 测,整个进程的峰值约 325 MB。16000×16000 的图,仅像素就接近 1 GB,实际峰值约 1.25 GB。限制压缩文件的字节数,挡不住这类输入。
所以 OCR 单独限制像素数:超过 5000 万像素就不识别,预览里说明图片过大。5000 万像素解码约 200 MB,这是给后续处理留余量后的选择,也不表示整个进程只会用 200 MB。
分块的释放时机同样影响峰值。6016×3384 的图,所有区域放在同一次请求里,峰值约 1 GB;每块单独请求、用完单独释放,降到约 250 MB。
还要测处理结束以后。修复前,长截图识别完闲置三分钟,内存仍在 233 MB;归还解码内存后,30 秒内降到 60–95 MB。对一个常驻菜单栏的小工具,只记录任务峰值还不够,它处理完以后会占着多少,也得知道。
文字和图片要不要存一起
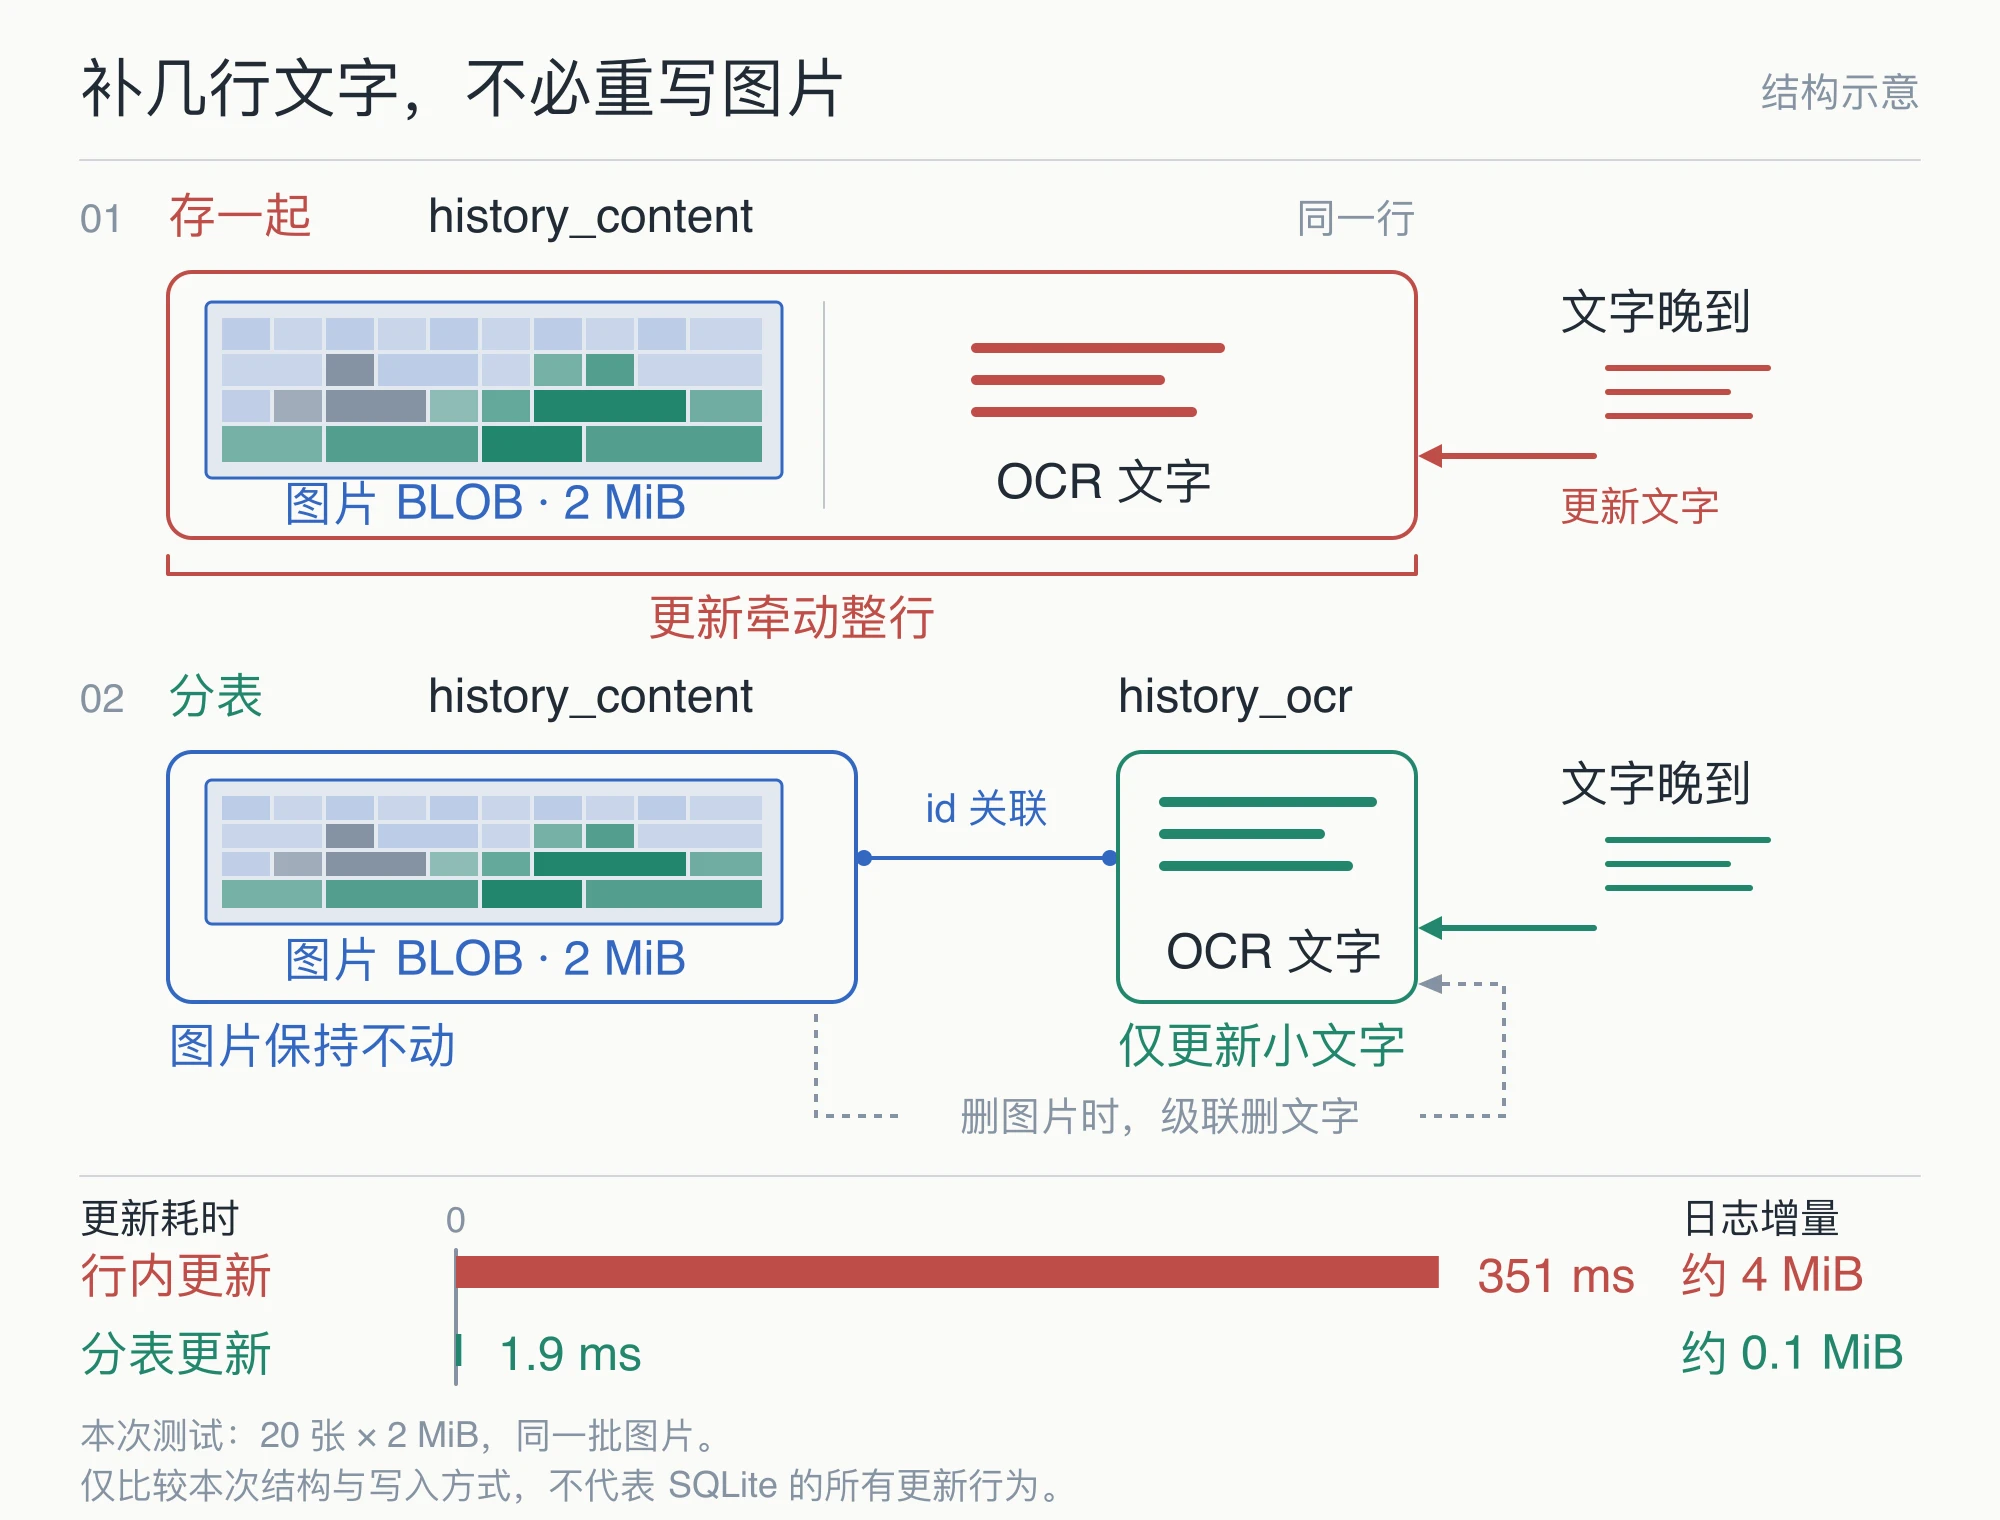
图片已经存在 SQLite 的 history_content 表里,给它加一列识别文字,看起来最省事。问题是,在这次表结构和写入方式下,更新那几行文字,会连带重写同一行中的图片内容。
20 张、每张 2 MiB 的图片,行内更新识别文字耗时 351 ms,写入约 4 MiB 日志;文字改存独立的 history_ocr 表后,耗时 1.9 ms,日志约 0.1 MiB。这是同一批数据的存储对比,不能当成所有 SQLite 更新的固定成本。
两份数据属于同一张截图,变化频率却不一样。图片存好后通常不再改,识别文字会晚一点补上,也会随开关被删除。把它们拆开,补写和清除文字都不用再碰图片。
独立表通过历史条目的 ID 关联,删除图片时一起删除文字。历史表只保留待识别、完成、失败三个状态,用索引找下一张任务。识别在后台逐张执行,耗时期间不持数据库写锁。
待识别状态也承担了任务队列的作用。应用重启以后,后台查询这些图片就能继续处理,不需要另存一份排队记录。
关闭再打开,旧结果就合法了吗
识别开始时开关是开的,几秒钟以后就未必了。用户可能已经删掉图片、清空历史,或者关掉了 OCR。写入前必须在事务里重新检查:图片仍然存在、仍在待识别,功能也仍然开启。
这还挡不住「关闭后马上重开」。后台取出图片开始识别,用户关掉功能、删掉已有文字,又重新开启。图片再次进入待识别,这时旧任务返回,前面三个检查都能通过,旧结果就会混进新的一轮。开关这个布尔值记不住中间发生过一次关闭。
修复只加了一个进程内的轮次编号,叫 epoch。任务开始时记住编号,开关改变时递增,写入时要求编号仍然相同。开关更新和结果保存使用同一把写锁,编号检查之后不会再插入一次开关变更。
旧任务返回错误也要丢弃。否则它可能把重新排队的图片标记成失败,新的识别反而永远不会开始。这比旧文字晚到更容易漏测。
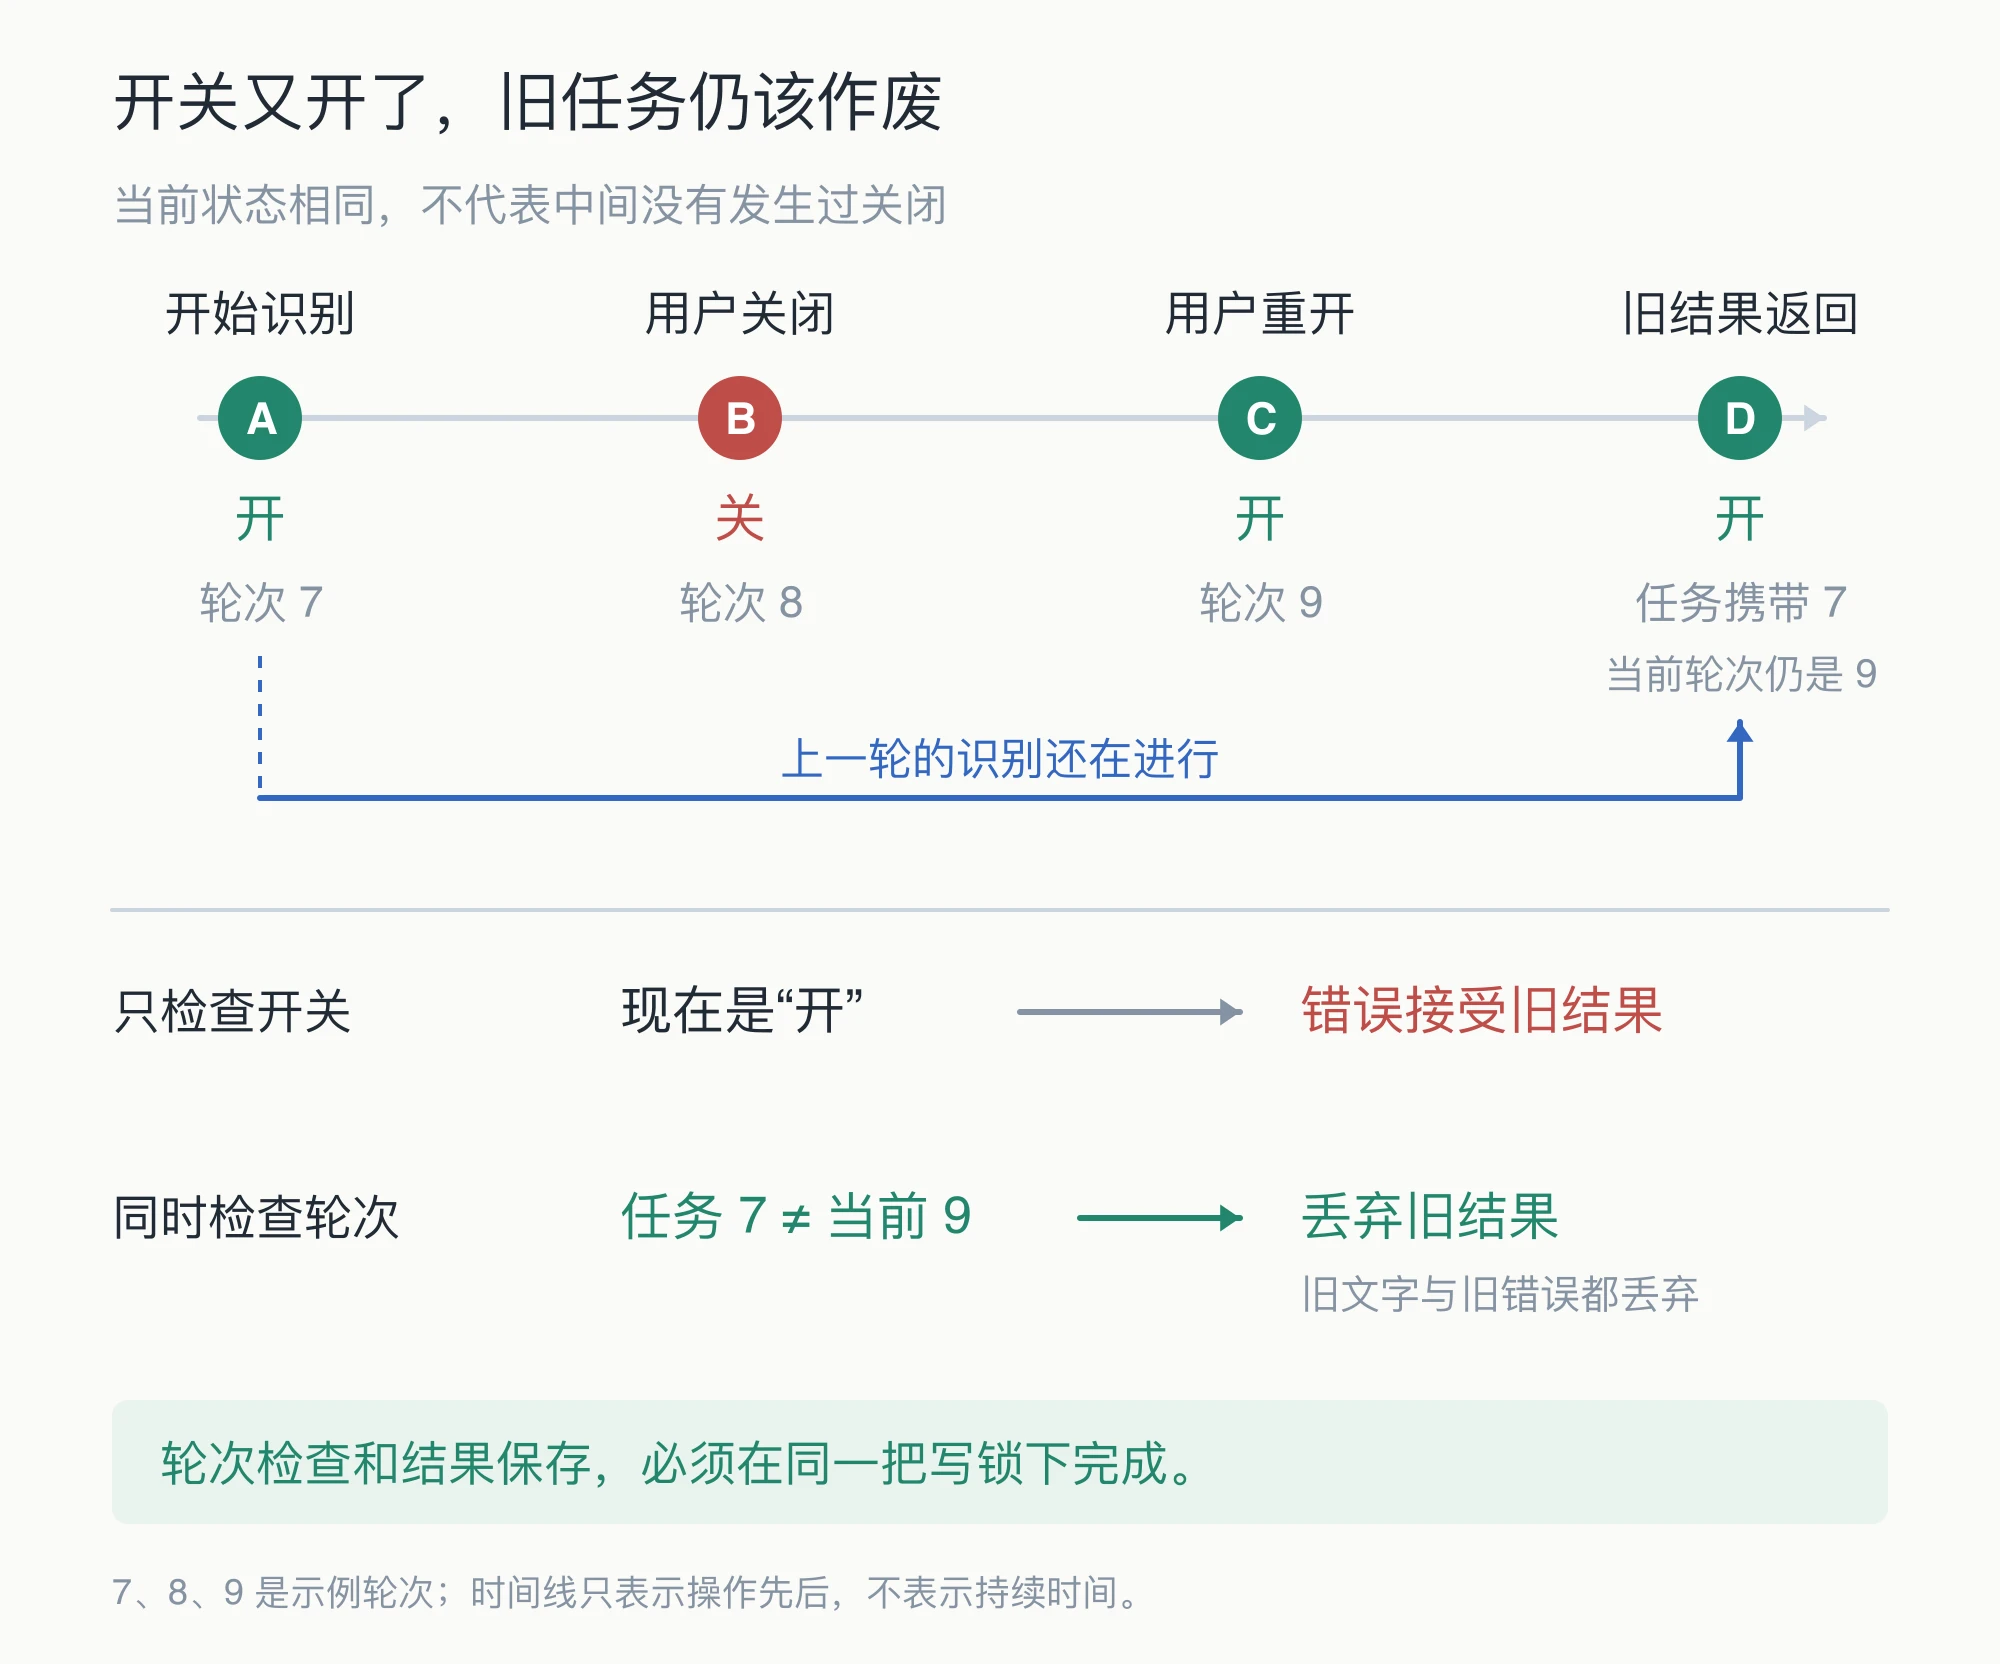
轮次适用于「当前状态恢复了,但旧任务仍应作废」的场景。搜索框从一个词改成另一个词,再改回原词,也可能遇到同样的问题;只比较当前关键词,区分不了两次请求。
关闭功能时,正文表之外还有标题和全文索引需要清理。识别文字已经成为图片标题和搜索内容的一部分,只删 history_ocr,其他地方仍可能留下片段。这里的删除范围要顺着数据被复制到哪里去查。
测试要能拦住哪些错误
后台循环的测试用了可替换的识别函数。假函数在返回前执行删除、清空、关闭再重开,就能把操作精确放在「取出任务」和「保存结果」之间。这样不用靠 sleep 碰运气,也能稳定复现旧结果写回的问题。
有了断言,再故意改坏生产代码,检查测试会不会失败。本轮分块合并试了 33 处变异,Vision 接线 8 处,后台循环 4 处,都被测试发现。例如去掉轮次检查,关闭重开的测试就应失败;边界归属判断改错,跨块那一行就应重复或缺字。
这些数字只说明测试拦住了这批故意制造的错误。比「测试全过了」更有用的问题是:如果有人去掉这条判断,哪一项测试会报错?
单测以外,还在独立 Bundle ID 和临时数据目录的原生包里走了后台识别、搜索和开关。这样能检查实际界面与数据库的连接,又不碰日常使用的历史。识别函数返回正确文字,不代表索引已经更新;设置页提示关闭,也不代表数据库里的文字已经删干净。
评测脚本和采用配置的测试入口保留在仓库的语料目录。在 macOS 上,安装 Pillow 后可以生成语料、调用应用实际使用的识别函数,再逐项看漏词:
python3 testdata/image-text-eval/make_corpus.py /tmp/clipnest-ocr-eval
CLIPNEST_IMAGE_TEXT_EVAL=/tmp/clipnest-ocr-eval \
  go test -run '^TestImageTextEvaluation$' -count=1 .
python3 testdata/image-text-eval/score.py /tmp/clipnest-ocr-eval -v
采用配置可以这样复跑;其他配置的对比来自开发时的一次性探针,探针没有提交。耗时数据测于 Apple M2 Pro、32 GB 内存、macOS 26.6.2,机器当时负载较高,只适合看量级和同一时段的差别。
目前质量评测主要用脚本绘制的截图,还没覆盖足够多的真实用户截图。真实图片里的字体、背景和抗锯齿会不同,macOS 13–15 上的识别质量也没有实测。下一轮要补的,是这些样本,尤其是现在会认错的文件名、相似字符和小字号。新样本进来以后,再看漏词清单,判断现在的分块和语言配置还是否合适。
Keep Reading
Discussion
Discussion loads when you reach this section.