Article
从 0 到 1 搭建自己的 Coding Agent(四):模型与 Provider,流式、前缀缓存与无状态请求
用一个单位换算的小例子接着往下搭:用户让 agent 修好 2m 转厘米时只返回 2 的问题。模型决定先读 src/convert.py,再读 tests/test_convert.py。
终端已经显示「先读实现和测试」,但两个 read_file 的参数还在往回传。实现文件的路径只收到一半,测试文件的路径倒是先齐了。此时该执行哪个?如果两份 JSON 都齐了,流的末尾又报错呢?
上一篇拿到了启动计划。这一篇从那里继续,把请求送出去,把返回接稳,再给下一轮留下能继续用的记录。
先约定上层究竟要拿到什么
这个系列里的 Provider,指负责适配模型服务 API 的那层代码。runtime 把内部消息、工具定义和模型选项交给它,它负责转换请求、消费响应,再交回内部结果。各项目的命名未必一样,这里按这个边界讨论。
先别急着写 HTTP。上层至少得和它约定好两种结构:
ModelRequest
  model          本次模型标记
  history        有顺序的消息、工具调用、工具结果及必要非文本项
  tools          工具名、说明和参数约定
  stream         是否需要增量展示

ModelReply
  status         ok / failed / cancelled
  text           收到的展示文本
  calls          完整调用候选:id、name、args
  finish_reason  归一后的终止原因
  usage          已知用量;未知字段不补零
  error          失败原因
  replay_items   下一轮协议要求保留的其他输出项
这是我们自己的契约,不是哪家 API 的字段表。实际实现可以用类型或数据类表达。后面的标准库实验就按其中这些字段返回结果。
把 text 和 calls 分开有个很实际的好处:界面可以先展示文字,执行管线只认完整候选。failed 也可以带回部分文字和已知用量,但不能靠「返回对象里还有点内容」推断本次成功了。
replay_items 也有必要。部分接口或模型要求下一轮带回非文本输出项。统一结构如果只剩一段文本和几个工具名,第一次请求可能看不出问题,续接时却已经丢了协议需要的东西。这些项应当按对应 API 保留和回放,不能把不同厂商的私有结构混着重传。
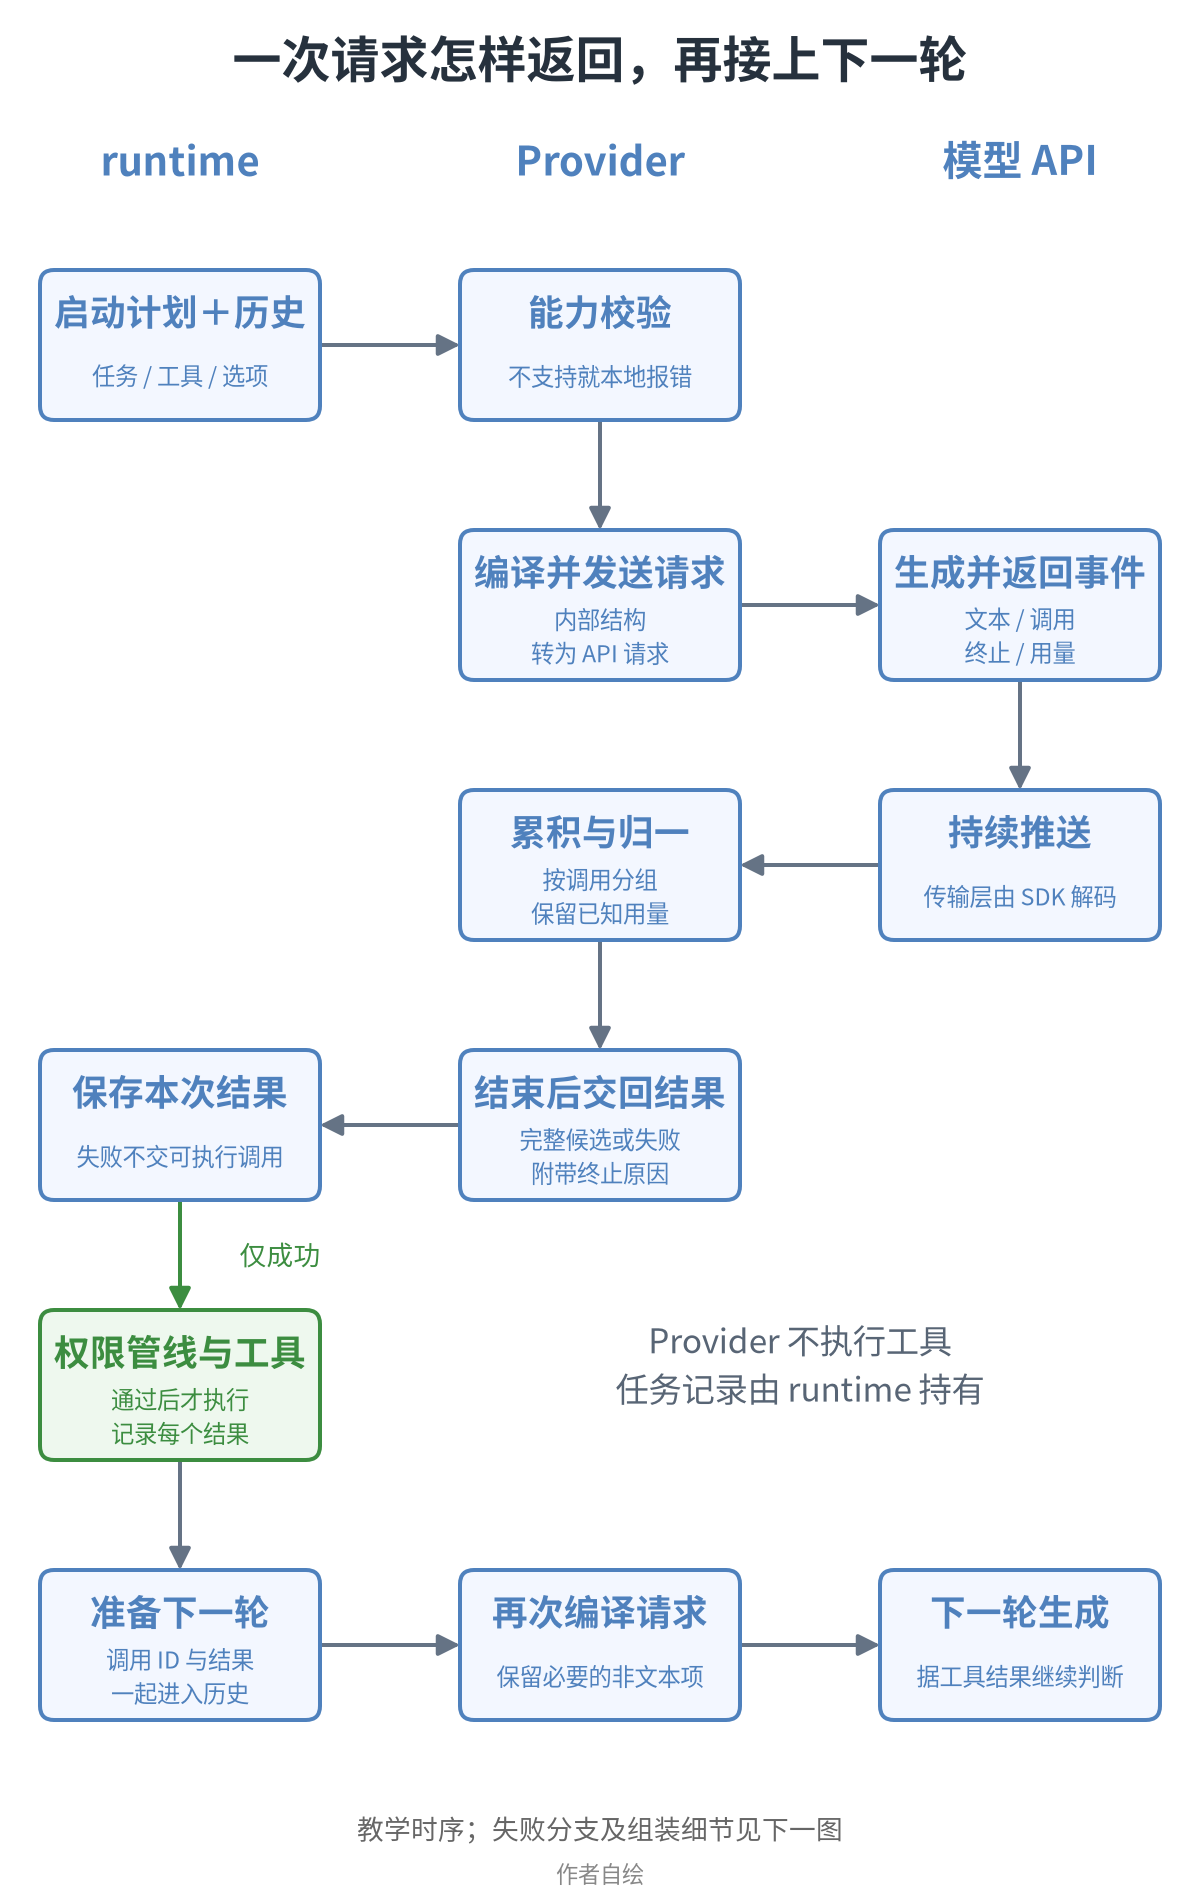
Provider 先检查要求能不能满足,再编译请求。比如选定的模型或端点不支持工具调用,教学实现就直接报错,不把工具列表悄悄删掉。真实项目也可能提供明确的降级路径,但要让上层知道降级了什么。
所以,换 base_url 只解决请求发到哪里。两端确实兼容同一份协议时,这样换很方便;一旦请求结构、工具表达或结束事件不同,就需要真正的适配。
OpenAI Responses用 function_call 输出项表示函数调用;Claude Messages把它放在 tool_use 内容块里。它们可以映射为同一种内部候选,但原生字段、调用关联方式和生命周期都得分别处理。错误和用量也在这个边界里,不能只适配成功时的文本。
流式有三层,别从字节直接跳到工具
我们拿到的「一块数据」,可能是三种完全不同的东西。
最底下是网络字节块。一次读取可以停在 UTF-8 字符中间,也可以只有半条 SSE 记录。它和模型打算说多少内容没有对应关系。
往上一层是完整 SSE 事件。解析器要处理记录边界,再解析事件里的数据。这里讨论的 OpenAI Responses 和 Claude Messages 直连 HTTP 流式接口都使用 SSE,但事件结构并不相同。
再往上,才是文本增量、工具参数增量、终止通知等模型语义事件。我们自己写的适配逻辑,最好从成熟 SDK 已经解好的这一层接手。下面的实验也从这里开始,不手写一个只能碰巧跑通的 UTF-8/SSE 解析器。
回到两个 read_file。适配后可以得到这样的内部事件顺序:
call_start  c1  read_file
call_start  c2  read_file
args        c1  {"path":"src/
args        c2  {"path":"tests/test_convert.py"}
call_end    c2
args        c1  convert.py"}
call_end    c1
finish      tool_calls
这些事件名是教学约定,不是真实 API 协议。
如果只用一个字符串缓冲区,两个路径会接到一起。最小实现也得有一张表:键是内部调用 ID,值里放工具名、参数片段和块是否结束。c2 先拼完,只更新 c2 的状态,不影响还在等待的 c1。
原始分片未必每次都带完整 ID。OpenAI Responses 的参数增量可以按输出项序号和标识关联;Claude Messages 用内容块的 index 定位参数增量。适配器先追踪原生槽位,在调用身份稳定后映射为内部 ID。这里不能假定「每来一块,就新建一个调用」。
现在 c2 的 JSON 已经合法了,能执行了吗?这篇先选保守策略:等整次返回正常结束,再统一校验并交出候选。
它会牺牲一点提前执行的机会,换来一个好检查的边界。UI 的进度展示可以很早发生,工具执行不跟着半成品走。更激进的调度可以以后再加,前提是先讲清楚某个块完成和整次响应异常之间如何处理。
JSON 完整,还差一次「能不能交付」的判断
有三种结束要分开:参数块结束,一次模型响应结束,整个编码任务结束。
第一种只说明一个块收齐了。第二种还要看结束原因,可能正常,也可能被截断或失败。第三种需要 runtime 根据任务进展继续判断。读完两份文件,显然还不能宣布单位换算已经修好了。
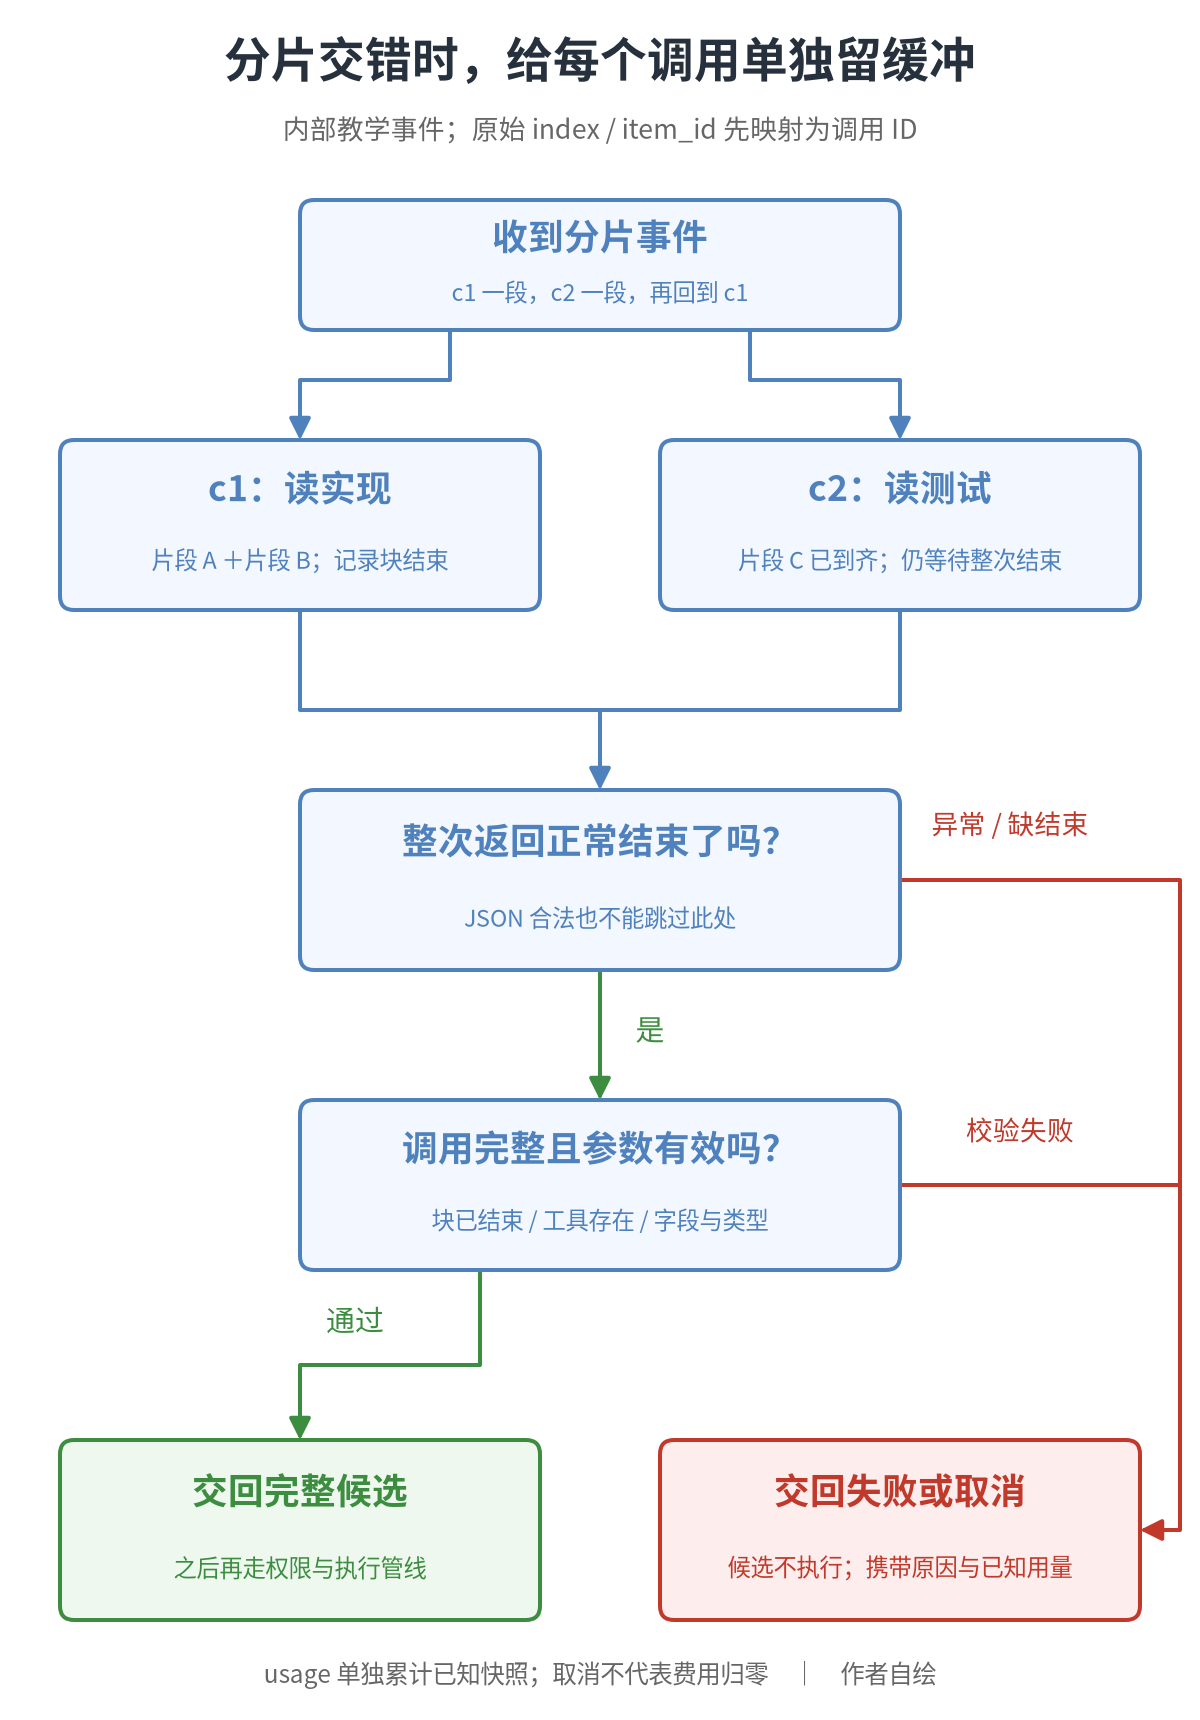
我们的归一层用 stop 表示正常的无工具返回,用 tool_calls 表示正常交付工具调用,用 length 表示截断。这些名字只服务于内部契约。真实适配时,Responses 的生命周期事件和 Claude 的 stop_reason、message_stop 要分别映射,不能照抄这几个字符串就算完成。
连接不再产生数据,也不自动等于正常结束。假设两个参数块都结束了,接着出现流尾错误,当前尝试仍然失败;如果 JSON 后面根本没收到预期终止,读到 EOF 也不能冒充成功。
用量要走一条独立的记录路径。流尾报错之前可能已经收到 usage。它说明本次尝试已有消耗,不能因为候选没提交就清零。Claude Messages 文档还明确说明,message_delta 中的用量是累计值,逐条相加会重复计算。
实验把用量归一成累计快照,同一字段覆盖更新,没收到的字段保持未知。取消时也带回最后已知快照。这个值未必是最终账单,本地停止读取不保证服务端立即停止生成和计费。
错误原因同样要留下。认证失败、不支持请求、限流、上游服务异常、传输中断,后续处理不同。正式实现可以给 error 增加类别、是否可重试和经过脱敏的说明;实验只使用合成错误字符串,避免把错误分类系统一起塞进来。
把交付边界写成一个能测的函数
下面这段是实验里决定是否交付候选的完整函数。calls 是前面那张调用表,每项有 name、parts 和 ended;reason 来自归一后的终止事件。
这是教学模拟,不调用真实 API,不执行工具。 本例只支持 read_file(path),有一个调用无效就整批拒绝。路径权限和工具真正能不能执行,留给后面的管线。
import json

def finalize(calls, reason, usage, error=None):
    result = dict(status='failed', finish_reason=reason,
                  calls=[], usage=dict(usage), error=error)
    if error:
        return result
    if reason not in ('stop', 'tool_calls'):
        result['error'] = '缺少正常终止,或返回被截断'
        return result
    if (reason == 'stop' and calls) or (reason == 'tool_calls' and not calls):
        result['error'] = '终止原因与调用内容矛盾'
        return result
    ready = []
    for call_id, call in calls.items():
        try:
            if not call['ended'] or call['name'] != 'read_file':
                raise ValueError
            args = json.loads(''.join(call['parts']))
            if (not isinstance(args, dict) or set(args) != {'path'}
                    or not isinstance(args['path'], str) or not args['path'].strip()):
                raise ValueError
        except (ValueError, TypeError):
            result['error'] = '调用未完成,或参数不符合约定'
            return result
        ready.append(dict(id=call_id, name=call['name'], args=args))
    result.update(status='ok', calls=ready)
    return result
这里故意先检查整次终止,再解析参数。即便参数是合法 JSON,只要流尾失败,结果仍然是 failed,calls 仍为空。参数通过校验,也只得到候选,不在函数里读文件。
把组装和交付分开之后,这段可以直接测,不需要开一个 HTTP 服务。完整的模拟程序还包括能力检查、事件收集和下一轮历史关联;测试文件可以一起保存到同一目录。Python 3.9 或更新版本就够,不装第三方包。
python3 stream_demo.py
python3 -m unittest -v test_stream_demo.py
程序内置的是上面的交错分片,并分别演示正常、完整参数后的流尾错误、完整参数后的取消。正常时得到 c1、c2 两个候选;后两种都不交付候选,但带回已知用量与失败原因。正常路径再用两份假文件内容构造下一轮,整个过程没有访问真实源码文件。
我实际跑了 30 项测试。其中包括两个调用交错、不同字符串切分点、坏 JSON、缺块结束、缺响应结束、截断、结束后继续收到内容、模拟断线、用量快照倒退,以及工具结果 ID 对不上。所有测试通过。程序里的 token 数和 cached 值都是合成数据,不是成本报告,也不是缓存命中实测。
要自己改一个地方试试,可以删掉 sample() 中的 finish 事件,保留两份完整参数。再运行,观察 calls 是否仍为空。然后恢复它,只把 c2 的 path 改成数字,看校验会不会挡住。这两步能检查你的实现到底是在「拼出 JSON」时放行,还是在约定的交付点放行。
沿 Orca 的一条调用路径读下去
实验省去了真实传输层。想看它落到项目里是什么样,可以固定读 Orca v0.5.20 的 DeepSeek 适配路径,避免跟着会变化的默认分支跑。
入口是 deepseek_http.rs 的 request_chat_streaming_with_budget。它先通过 conversation_to_api_messages 编译历史,构造模型、消息、工具等请求字段,并在流式选项中请求返回用量。到这里才发 HTTP。
字节流交给 streaming.rs 的 parse_sse_response_with_partial。往里读,process_complete_lines 处理跨网络块的行数据,StreamAccumulator::push_line 消费完整数据。工具参数经过 accumulate_tool_call,按 delta.index 找到缓冲槽,ID 到达后记录,参数则持续追加:
if let Some(ref args) = func.arguments {
    buf[idx].arguments.push_str(args);
}
这也解释了为什么进度事件不能直接当执行指令:收到一个参数片段时,连稳定 ID 都可能还没到。这里真正维护的是带身份和生命周期的缓冲状态。
同一个 push_line 里,有一小段顺序值得看:
if let Some(chunk_usage) = chunk.usage {
    self.usage = Some(chunk_usage.into());
}
if let Some(error) = chunk.error.as_ref().filter(|error| reports_error(error)) {
    return Err(stream_error_message(error));
}
先保存用量,再返回上游错误。外层的 StreamParseError 同时带原因和已知用量,取消、超时及提前 EOF 等路径也尽量把已知消耗带回去。它的 finish 检查则按自己的协议约定处理结束标记,并没有要求所有 API 都同时出现相同的标志。
回到 request_chat_streaming_with_budget,正常解析后还要处理结束原因、解析调用,最后才形成 Provider 的结果。在普通工具请求路径里,length 之类的结束不能混成正常交付。
这里有两处和教学实验不同,读源码时别硬套。
一处是坏参数。这个版本的测试 streaming_invalid_tool_arguments_are_returned_for_tool_failure 表明:传输正常但参数无效时,它可以保留原始参数,返回未解析成有效目标的调用,交给后续工具失败反馈,让模型纠正。我们的实验直接拒绝整批。两种选择的共同要求是无效参数不能进入实际执行,错误反馈放在哪层可以不同。
另一处是重试。这个 Provider 内部有受预算限制的流完整性重试,还检查是否已经发出进度,并合并不同尝试的用量。因此不能简单规定「所有重试只能在 runtime」。更实际的约束是上下层共享重试预算,别各自重试三次,最后请求次数相乘。
不过,请求重试和工具重试仍得分开。重新发一次模型请求,可能拿到新的调用 ID 或新的参数;它不能替你证明上一次写文件、发请求或执行命令有没有完成。call_id 用来关联调用和结果,也不自动提供全局幂等。执行去重需要 runtime 自己的操作、尝试和结果记录,后面写 runtime 时再展开。
前缀缓存,先拿两轮输入比一下
读实现和测试之后,agent 还要继续请求模型。此时固定指令通常没变,之前的历史也还在,新增的是刚才的调用和工具结果。
前缀缓存可以复用服务端已经算过的输入前缀。能复用到哪里,取决于模型实际看到的输入和该服务的缓存规则。我们先只看自己能控制的逻辑顺序。
设 S 是固定指令,H 是首轮已有历史,ΔH 是首轮之后追加的调用和工具结果。两轮跨了日期,日期片段从 D1 变成 D2;工具定义和模型保持不变。
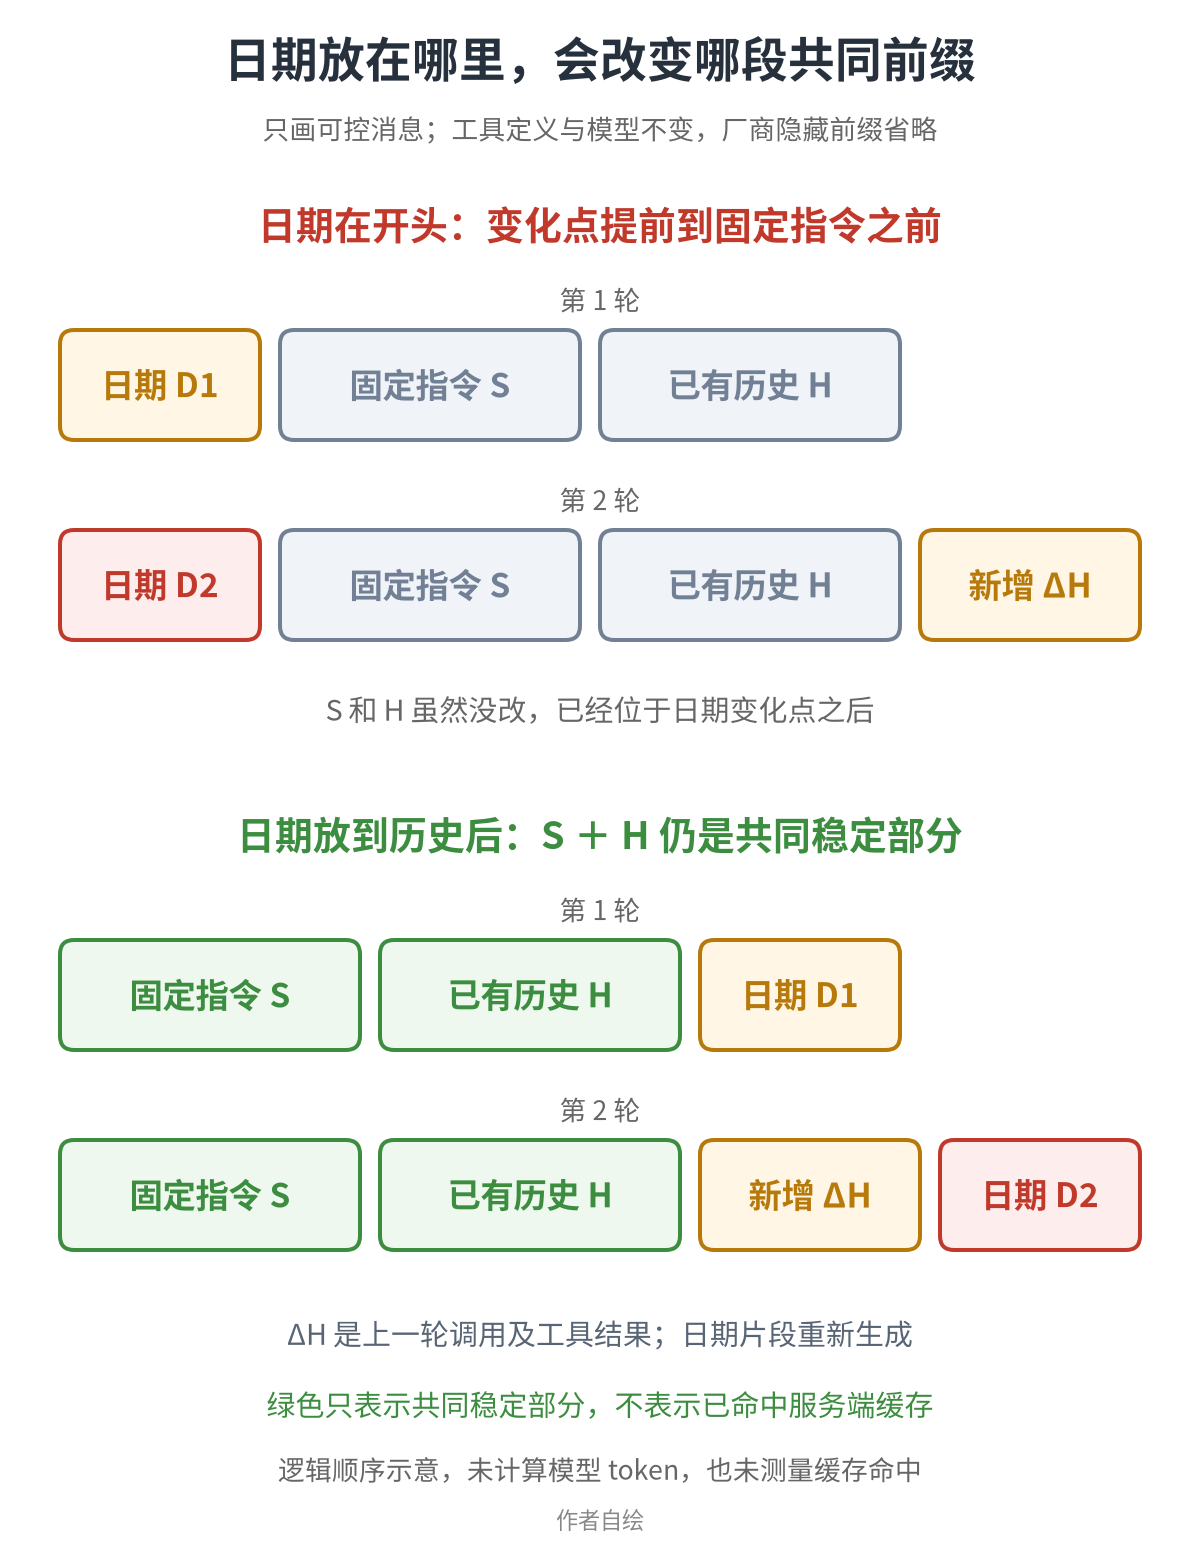
上半部分先放日期。第二轮还没读到 S,就已经遇到不同内容。后面的 S、H 即使没动,也不能据此算作从开头连续匹配的那段。
下半部分把当前日期作为单独的动态片段放到已有历史之后。第二轮保留 S、H,再追加 ΔH 和更新后的日期,前面那段稳定内容就更容易保留下来。
这图省略了厂商隐藏前缀,也没有画工具 schema 的内部渲染。它说明的是可控消息顺序如何影响变化点,不代表上半部分所有缓存都被清空,更没有把彩色方块当成真实 token 边界。
Orca v0.5.20 的日期处理可以沿代码核对。runtime 的 runtime_turn_opening.rs在轮次入口更新 conversation.set_today(...),日期放进内部上下文;system_prompt.rs 有测试确认固定系统提示不含 Today's date。
再接着读 deepseek_http.rs 的 conversation_to_api_messages,它先序列化历史、工具调用和工具结果,历史处理完之后,才把 render_internal_context(conversation) 渲染出的动态片段追加到消息末尾。context.rs 中的同名函数负责渲染内部上下文。这样就能从「日期在哪里更新」一路追到「请求里最后放在哪里」,不用只信发布说明的一句话。
这条代码路径说明了它怎样减少动态内容对既有前缀的改写,不能据此推算缓存命中率。
OpenAI 的缓存文档同样建议稳定内容在前、动态内容在后,但真实复用还受模型支持、可缓存边界、路由和有效期等条件影响。显式缓存断点也只适用于文档明确支持的模型与 API,不能套到所有兼容接口上。
实际整理请求时,我会先固定工具定义和固定指令的生成方式,保留既有历史,在末尾追加真正新增的内容。若接口支持 allowed_tools 这类能力,可以评估保留工具定义、单独限制当前可用子集。是否支持、如何渲染,仍要按具体接口核验。
这里做的是减少无意变化。比较两个 Python 字典的键顺序,或者计算两段字符串的共同前缀,都不能代替模型 token 和服务端命中数据。权限真的变了,就更新有效请求;不能为了缓存继续带旧权限。
缓存命中只是让服务端少重复算一段输入,不会替 agent 保存任务记忆。下一轮需要的历史和工具结果,仍要按接口要求提交或续接,不能因为上一轮命中过,就把必要上下文省掉。
最后把工具结果接回去,才算接完一次请求
c1 和 c2 通过后续执行管线,拿到两份文件内容之后,下一轮得能认出哪份结果回答了哪个调用。
在 OpenAI Responses 的函数工具路径里,模型输出的 function_call 带 call_id,客户端用同一个值回传 function_call_output。下面只摘出关联字段,示例 ID 是假值:
{
  "type": "function_call",
  "call_id": "c1",
  "name": "read_file",
  "arguments": "{\"path\":\"src/convert.py\"}"
}
对应的工具结果是:
{
  "type": "function_call_output",
  "call_id": "c1",
  "output": "假实现内容"
}
结果靠 ID 对应,不能靠「第二个结果应该属于第二个调用」。并行执行时完成顺序可能不同;读两次同名工具也不能靠工具名区分。实验中的 next_history 因此要求结果 ID 集合与候选调用精确对应。
接下来有两种会话组织方式,要按选定 API 分开实现。
客户端自己管历史时,把需要的旧输入和完整响应项保留下来,再加入本轮工具结果。对 Responses 来说,官方会话状态文档展示的是保留 response.output 等所需项,不能只摘 output_text。适用模型要求的非文本项、关联信息,也要继续带着。附件里的 replay_items 只是用一个不透明的合成项演示「不要在统一结构里丢掉它」,没有模拟真实 reasoning 协议。
如果使用 Responses 的 previous_response_id,就由服务端接上它已保存的响应,再按接口要求传入本轮新增项。此时不必把「客户端重传完整历史」那套机械地叠加一遍;上一轮哪些配置会继承,也要遵循该接口规则。
所以,说一次请求无状态,通常是在讲客户端需要提供足够的请求上下文。服务端有状态的续接 API 是另一种实现选择。两者都不等于 agent 没有任务状态,更不能据此推导服务端是否保存数据。
工具到底有没有执行、哪次尝试被取消、审批停在哪里,这些记录依然属于 runtime。Provider 帮它接模型,并不会因为拿到了一个响应 ID,就替它持有完整的任务执行记录。
搭到这里,可以先拿实验里的事件驱动自己的 Provider 边界:成功时交付两个候选,截断或流尾错误时不交付,失败仍保留已知用量,下一轮工具结果能按 ID 对回去。把这条路径跑稳,再接真实 SDK,出了问题就能分清是在协议适配里,还是已经到了执行管线。
Keep Reading
Discussion
Discussion loads when you reach this section.