Article
给 Coding Agent 加一颗「后悔药」:/rewind 的工程复盘
有一类事故,用 git 救不回来。
Agent 在一个没提交过的工作区里连续改了十几个文件,前三轮顺着一个错误方向越走越深。你想把代码和对话都退回到第 3 轮之前:git status 只看到一堆未提交改动,git checkout 没有可回的提交,撤销对话记录更是没有入口。最后只能手动翻看 transcript,猜哪些文件是那几轮改的,再一个个还原。
Claude Code 的用户对 /rewind 很熟悉,Orca 之前没有。这次把它补上了:v0.5.19 里的 /rewind(命令里叫 orca rewind)可以按「用户轮次」回退,选文件、选对话,或者把要丢掉的一侧换成模型摘要。
功能上线之后回头看,真正难的不是「把文件写回去」,而是四个问题:恢复的粒度到底是什么、数据放在哪、崩溃之后怎么办、以及怎么证明它在所有平台上都对。 这篇按这四个问题复盘一遍。
撤销的粒度,不是文件,是「一轮对话」
一开始最容易想到的方案是「给每个文件做版本」,像编辑器里的本地历史那样。但 Agent 的工作单位不是文件,是一轮对话:用户说一句,模型读文件、调工具、改代码,这一轮结束时,代码和对话一起前进了一步。
如果只回退文件,对话里还留着「我已经把它改成 X 了」的上下文,下一轮模型会继续基于错误前提工作;如果只回退对话,磁盘上的文件又停在未来。两种半吊子状态都比不撤更危险。
所以检查点被定义成一次「轮次边界」:这一轮里所有被 edit / write_file 改过的文件,加上对话进行到的位置。用户在 /rewind 里选一轮,其实是选「回到这一轮开始之前」。
这件事也解释了为什么不直接复用 git:git 的提交粒度由人决定,而 Agent 的中间态恰恰是没提交的那些;对话回退和文件回退必须是同一次操作,git 管不了另一半。
从 Claude Code 学到什么,哪三件事没照抄
Claude Code 的 /rewind 证明了这个方向可行。它的核心思路很值得学:在工具修改文件之前存一份「前像」,用 transcript 里的快照元数据把轮次和文件关联起来,回退时按「有效历史」截断对话。
但实现细节不能直接照搬,至少有三处我们改了口径:
- 路径必须校验,失败要响。快照记录的是当时的绝对路径,如果用户换了工作目录、或者会话被复制到另一台机器,直接按旧路径写回就是往错误的地方写。Orca 在回退前比对会话记录的
cwd和检查点的 root,不一致就拒绝,而不是「尽力恢复」。 - 不是所有写入都能被捕获。只有经过内置
edit/write_file的文件才有前像;bash里跑sed、外部进程、其他会话改的文件都不算。这些文件会被列成untracked,回退时明确告诉你「它们不会被恢复」,不制造「已经全恢复」的错觉。 - 保留多少个检查点,是可以配置的产品决策。默认保留最近 100 个可文件回退的检查点,更早的只保留对话回退能力;淘汰时写一条
session.snapshot_retention水位记录,再按「仍被引用的 blob 集合」做 GC。不用把整个 session 的文件都留着。
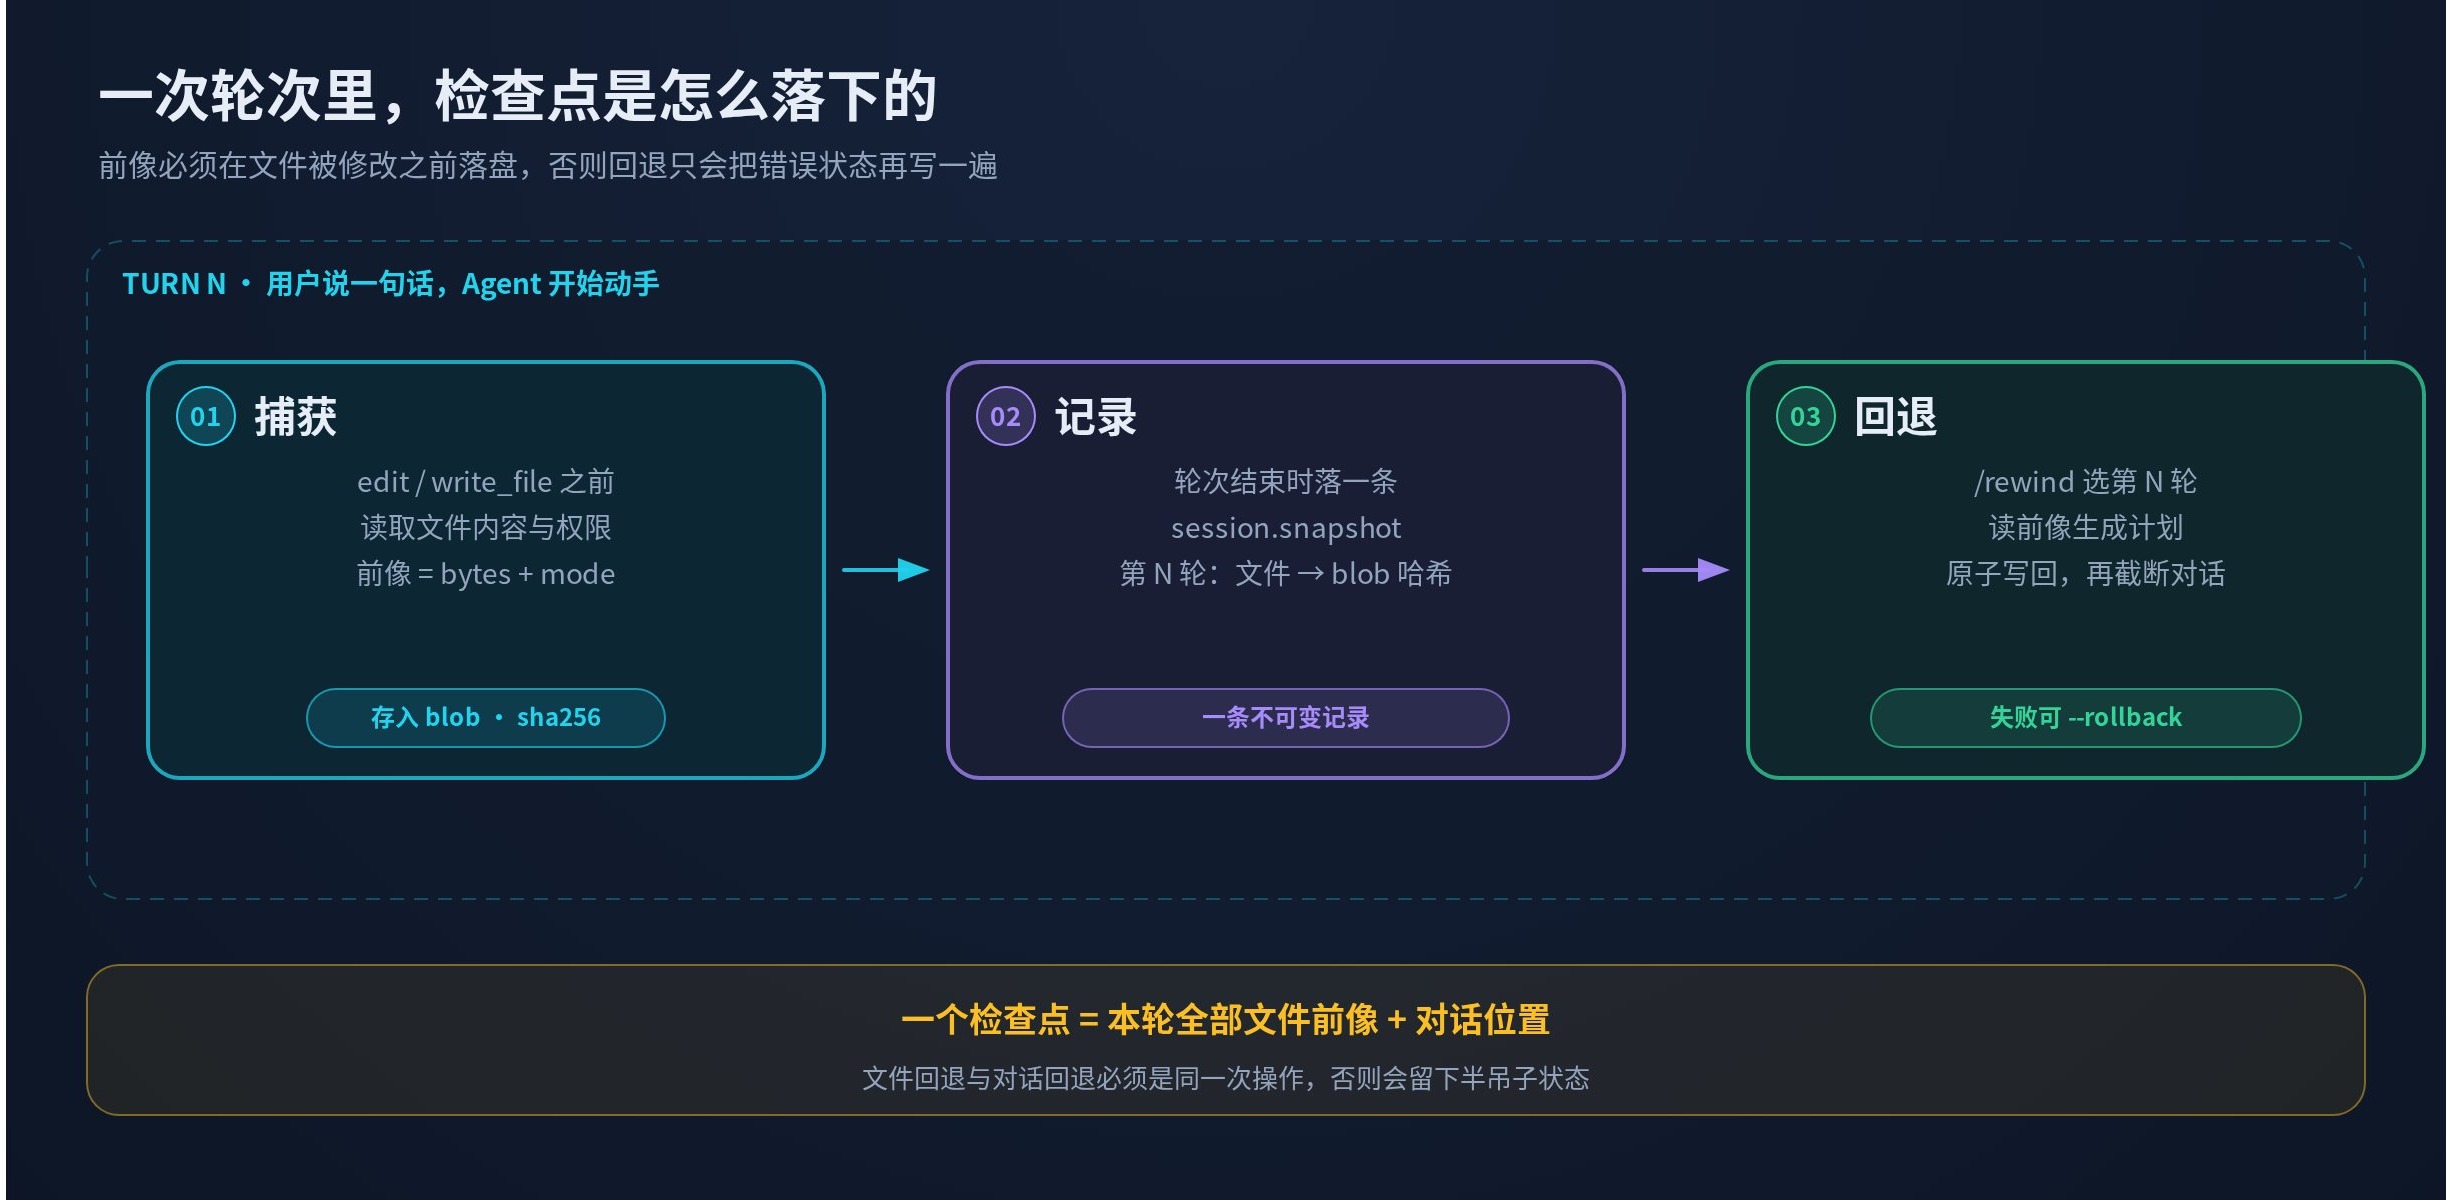
图里最容易被忽略的是时序:前像必须在修改之前落盘。如果先改文件再存,存下来的就是「改完之后」的内容,回退时只会把同一个错误状态再写一遍。这也是为什么捕获逻辑挂在工具调用的 pre-image 阶段,而不是等 turn 结束再统一扫一遍。
一份 transcript,两种数据
快照的数据其实分两层,混在一起会很难受:
- 关系数据放在 transcript 的 JSONL 里:
session.snapshot记录「第 N 轮,哪些文件,各自的前像哈希」,session.rewind记录「从哪一轮回退、回退方式、保留了多少条消息」,session.snapshot_retention记录淘汰水位。 - 文件内容放在内容寻址的 blob store 里:
objects/…/<sha256>,zstd 压缩,保留原来的 mode。相同内容只存一份,多个检查点引用同一个哈希。
这样做的直接好处是 transcript 保持 append-only,仍然是审计和 resume 的事实来源;blob 可以独立 GC,也可以跨检查点去重。代价是要自己处理引用关系:哪些 blob 还活着、淘汰水位以下的快照还能不能用、--prune 什么时候能删。
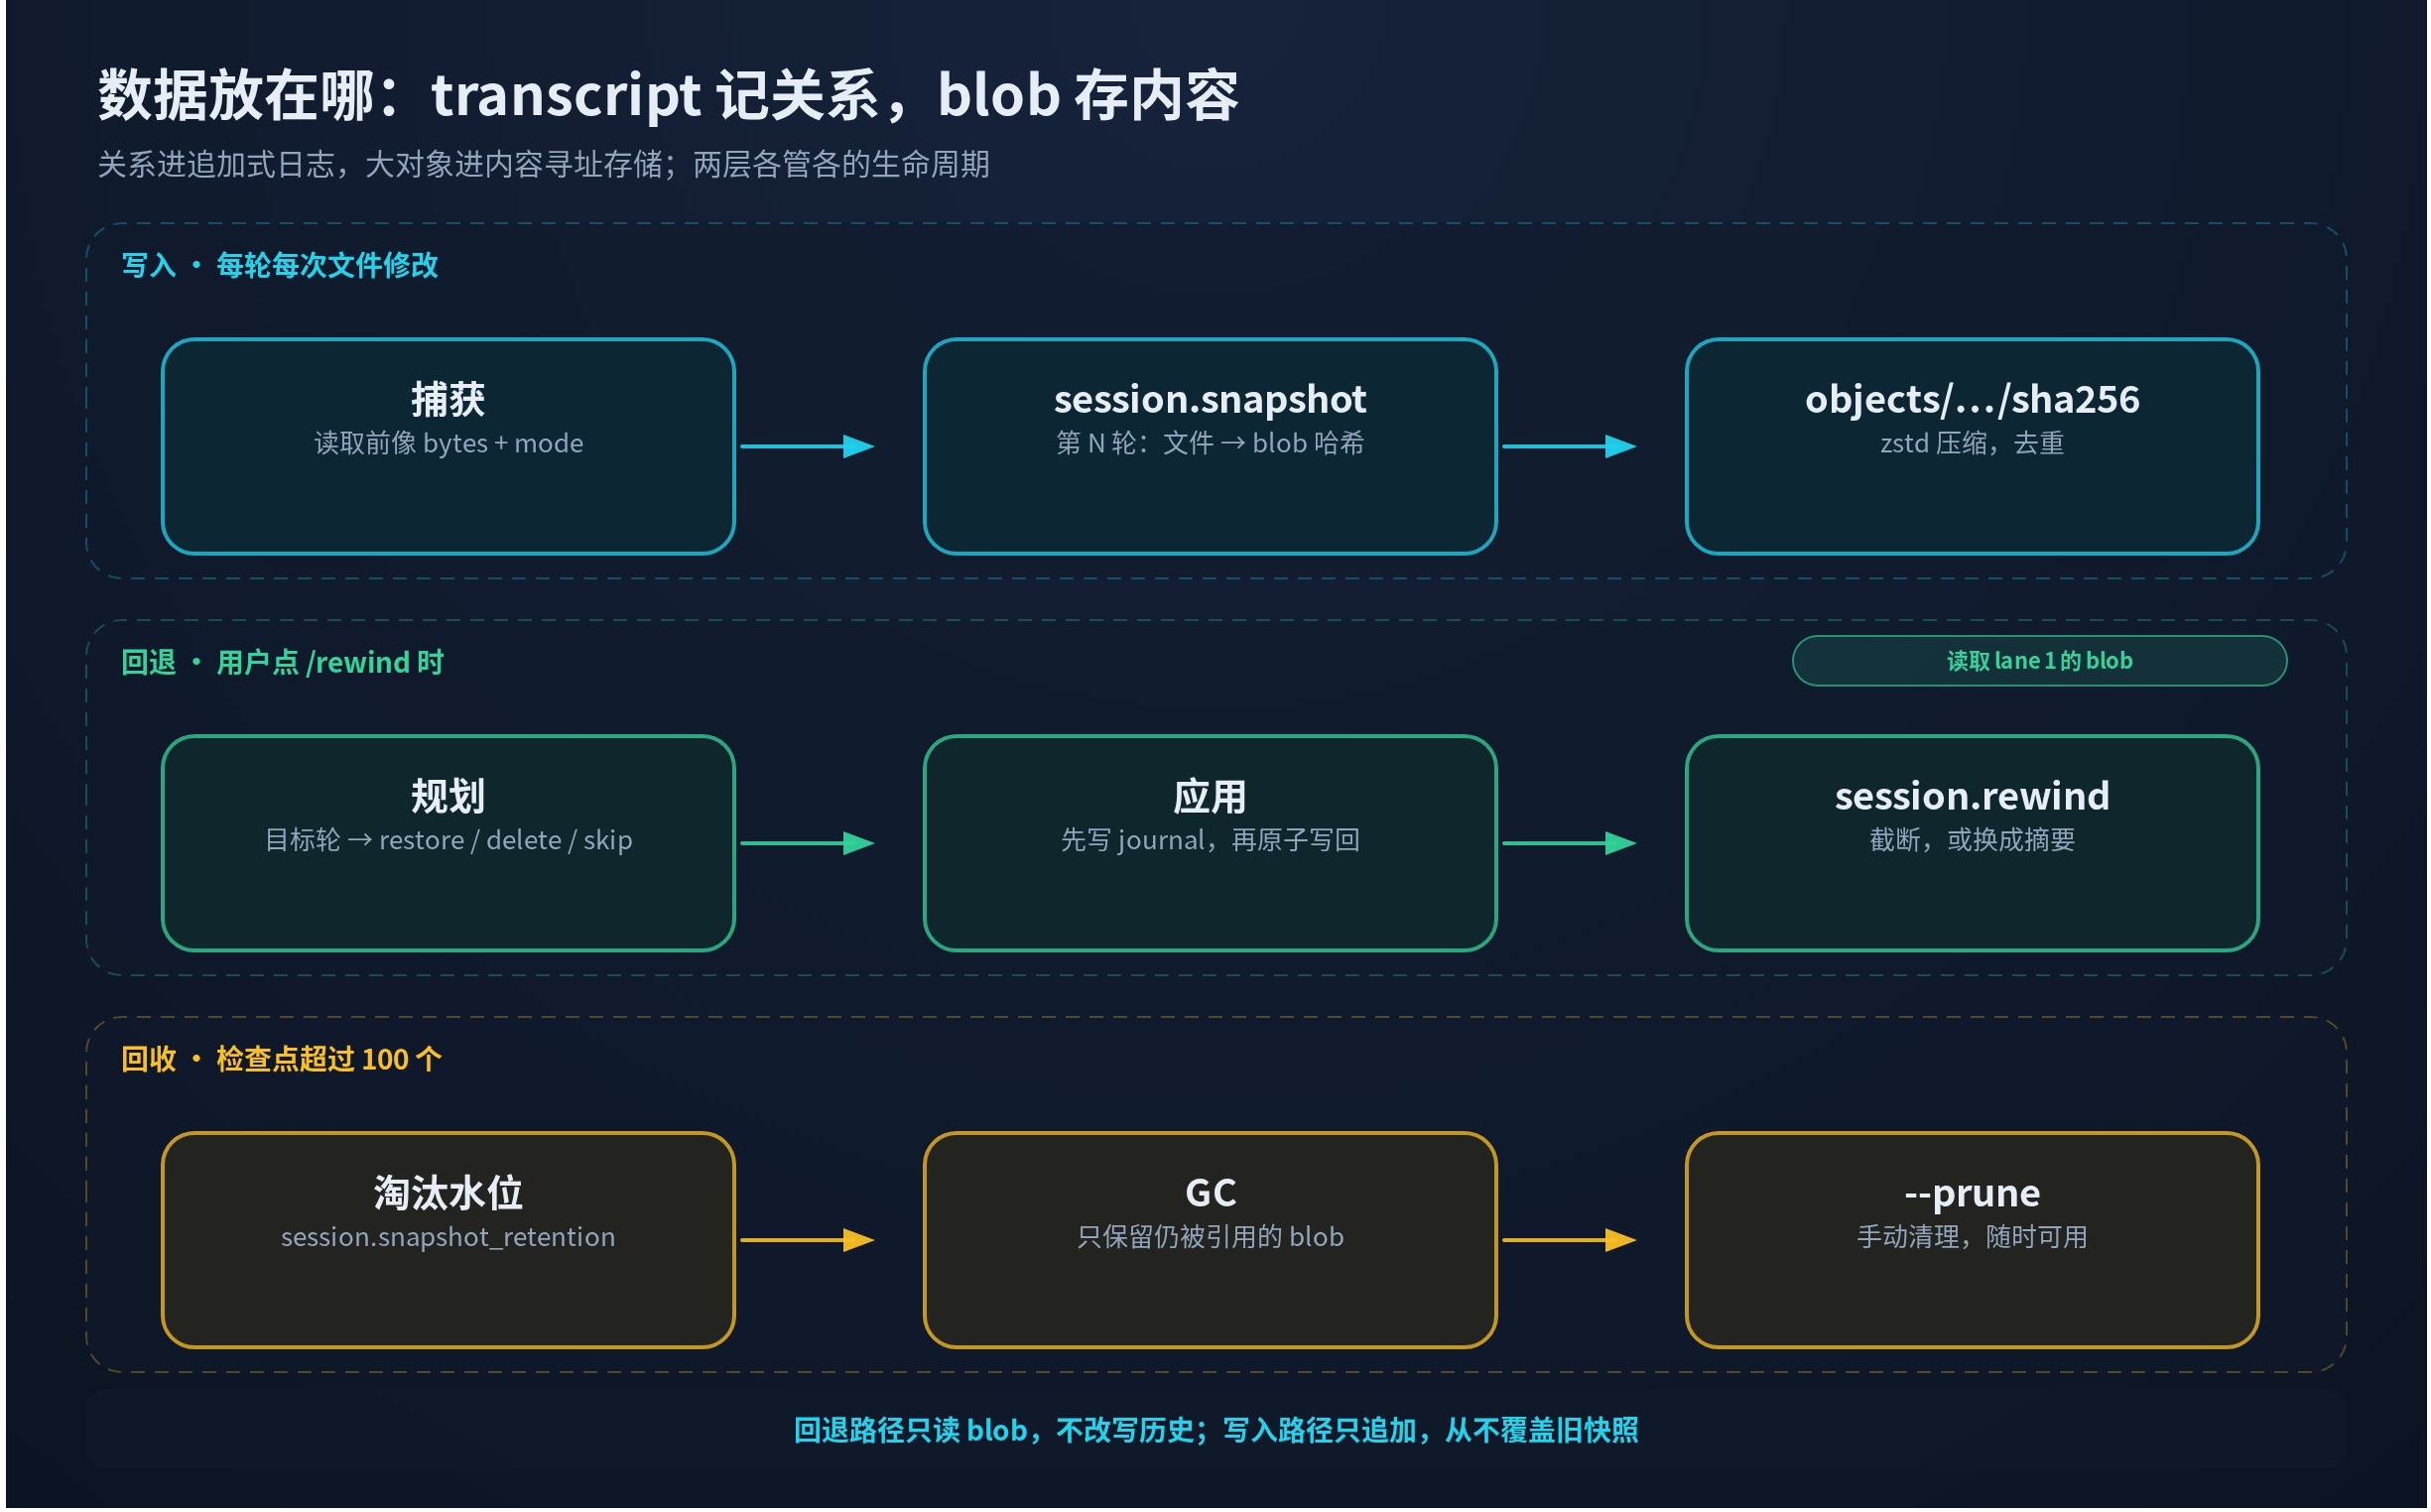
真正动手时还遇到几个边界:单个文件超过 16 MiB 不做前像,只标 skipped;只捕获工作区 root 以内的文件,.git、target、node_modules、.orca 目录直接跳过;符号链接和目录不做前像,避免在某些平台上把链接目标改坏。Windows 上的文件替换没有 POSIX 的原子 rename 语义,所以写回流程得自己保证「要么全部成功,要么能回滚」。
六种出口:先问「要恢复什么」,再问「怎么恢复」
一开始我们只设计了三种模式:文件和对话都回退、只回退文件、只回退对话。做 UI 的时候发现不对:用户经常只是不想在上下文里留着那几轮试错,文件本身想保留;也有人只想把文件改回去,对话继续接着聊。
最后落成五个 CLI 模式、TUI 里六个选项(多一个取消):
both:恢复文件,截断对话;code:只恢复文件,对话不动;conversation:只回退对话,文件不动;summarize-from:把选中轮次及之后的内容替换成一条模型摘要;summarize-up-to:把选中轮次之前的内容压成一条摘要;- 以及取消。
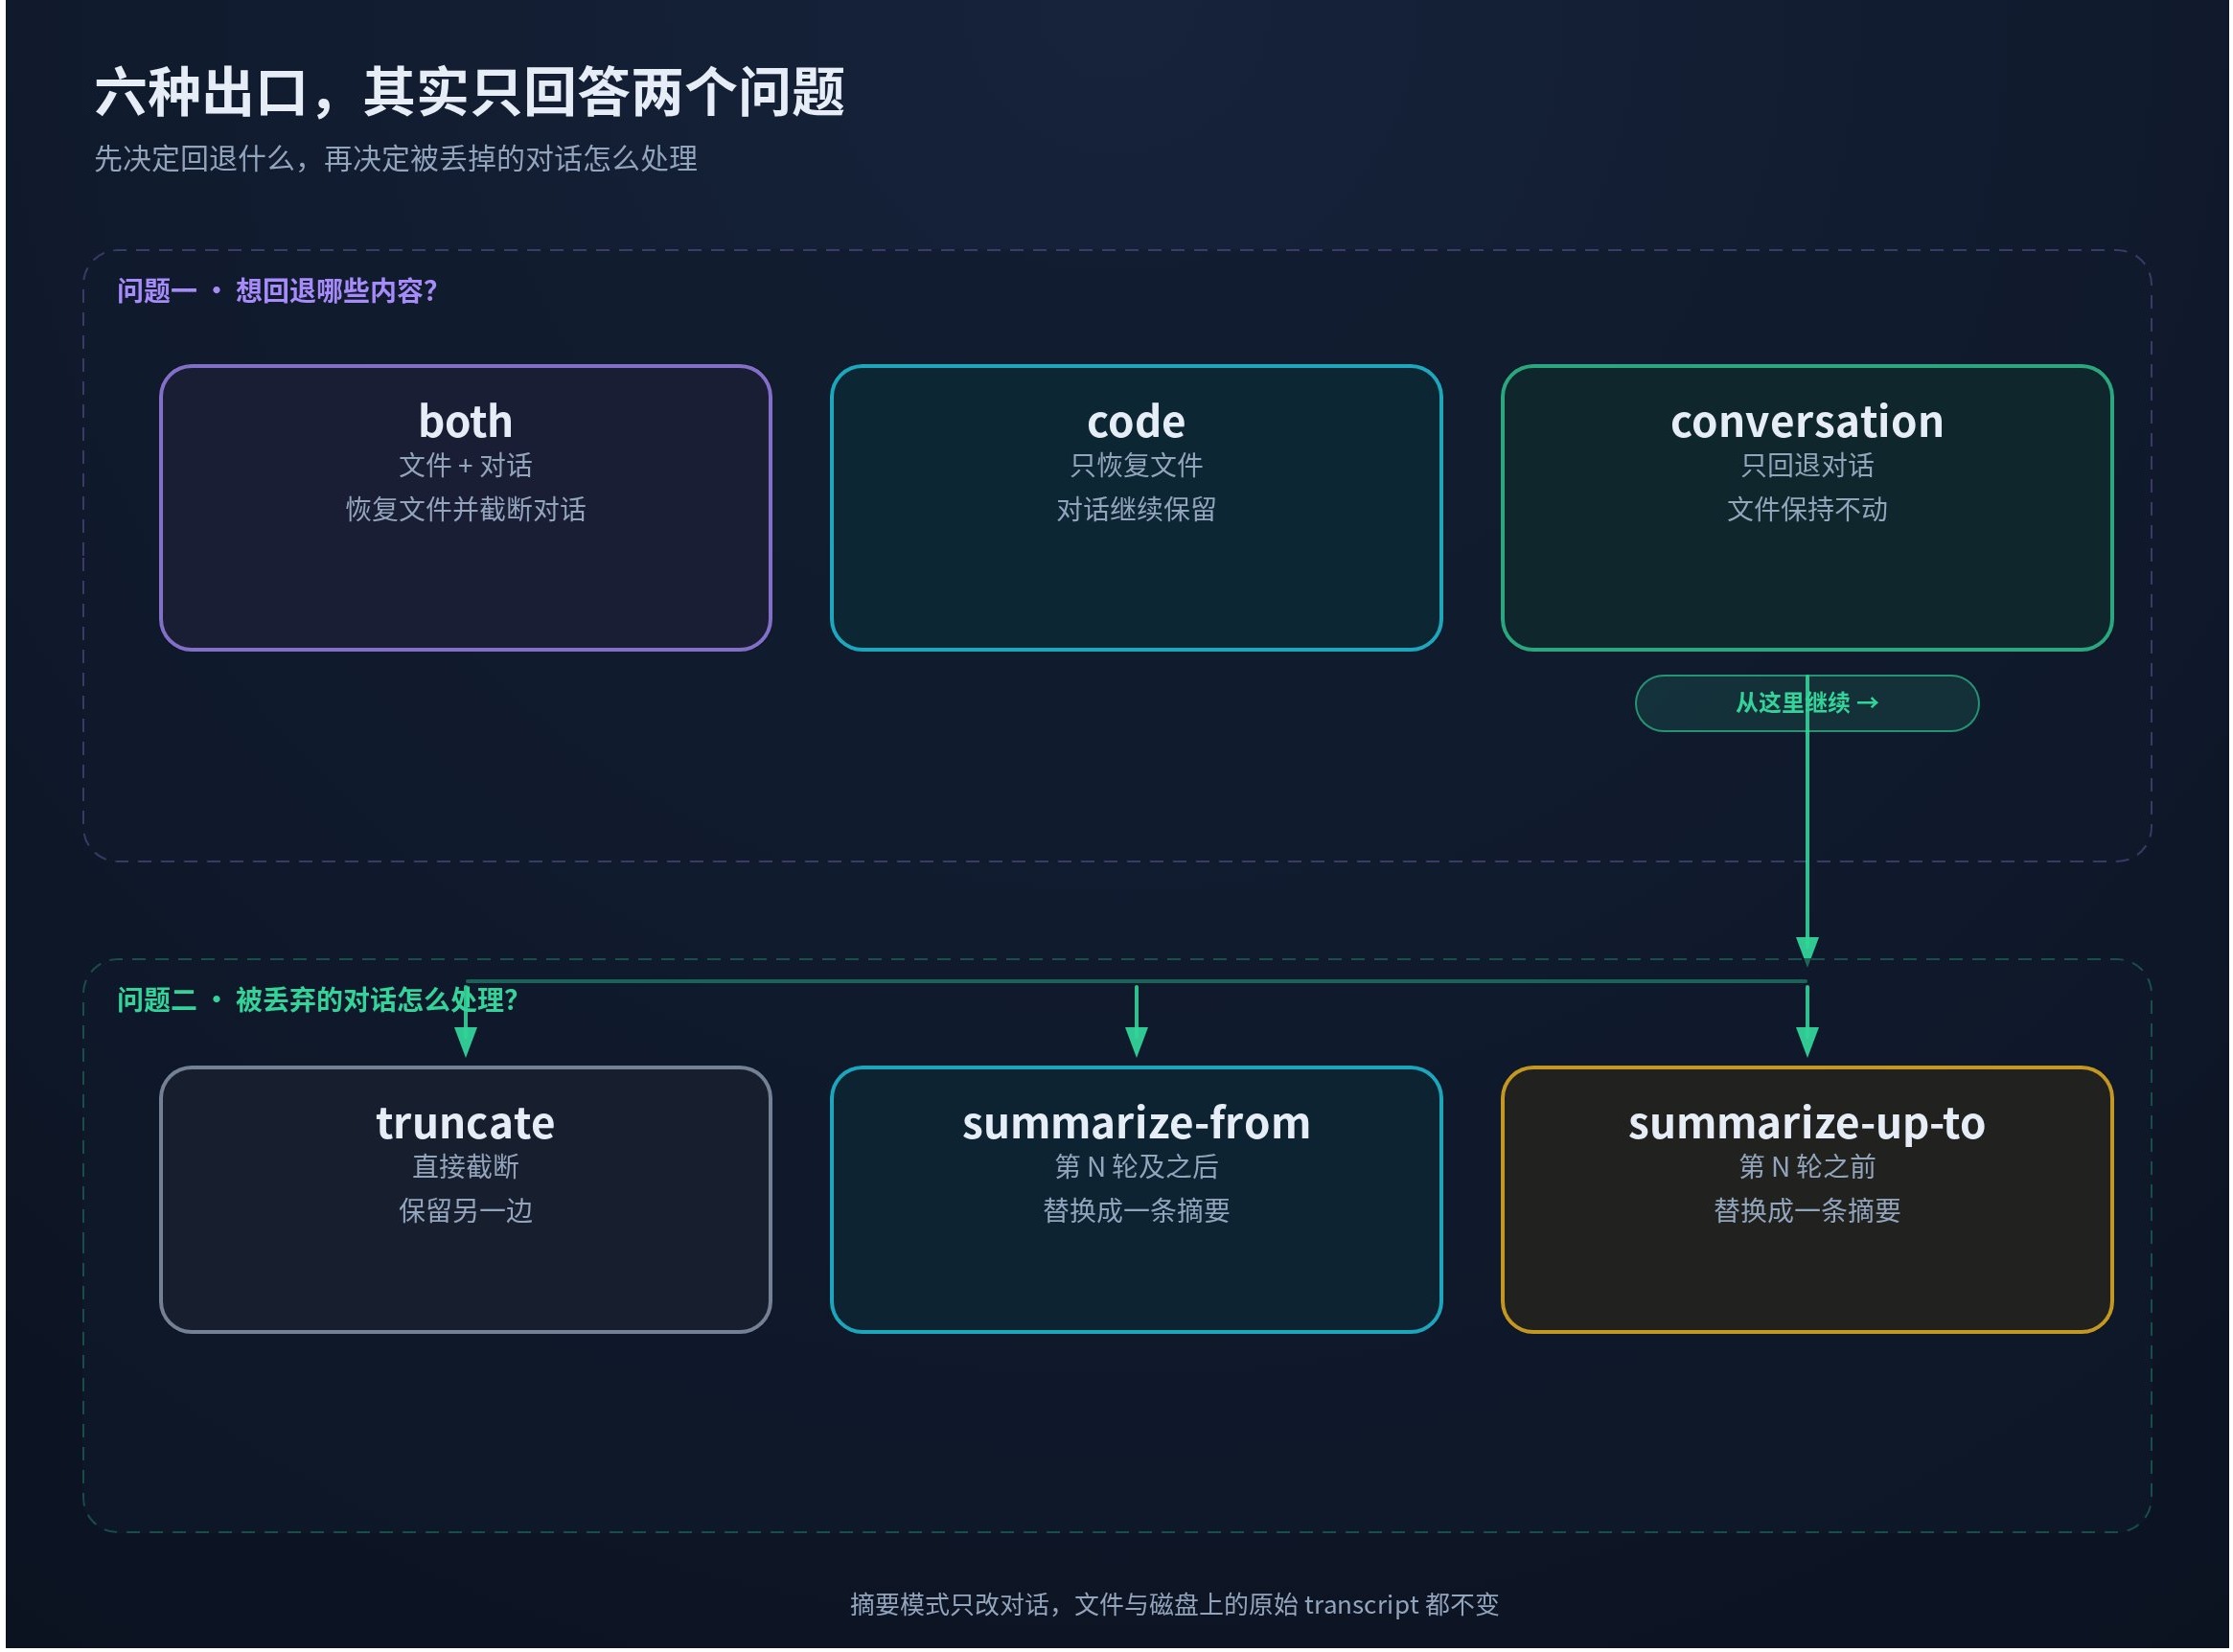
有一个坑值得单独说:摘要模式不能直接复用现有的 context compaction。压缩器有自己的触发阈值和「压缩到哪」的策略,而复退需要的是「从指定消息边界切开,只摘要一边」。我们最后新写了一个 summarize_range,显式传入边界、保留 system prompt 和 pinned context,并且把摘要调用真实产生的 usage 按当前模型价格折算进成本,而不是记 0。
另一个细节是 dry-run:预览只生成计划和文件 diff,绝不调用模型。这样用户在确认之前不会产生一次不可撤销的摘要费用,回退操作的「预览」才是真的可预览。
崩溃安全:两阶段写回和可回滚
回退要改多个文件,中途可能失败:磁盘满了、权限不够、进程被 kill、Windows 上文件被占用。最糟的情况是「改了一半」,此时既不是旧状态,也不是新状态。
做法是两阶段:先把计划写成 journal(操作 id、每个文件的目标哈希、旧内容的位置),再逐个文件用 temp + rename 替换。全部成功后删 journal,追加 session.rewind;任何一步失败就保留 journal,下一次文件回退会被 pending journal 挡住,用户可以用 orca rewind --rollback OP_ID 按 journal 把旧内容恢复回来。
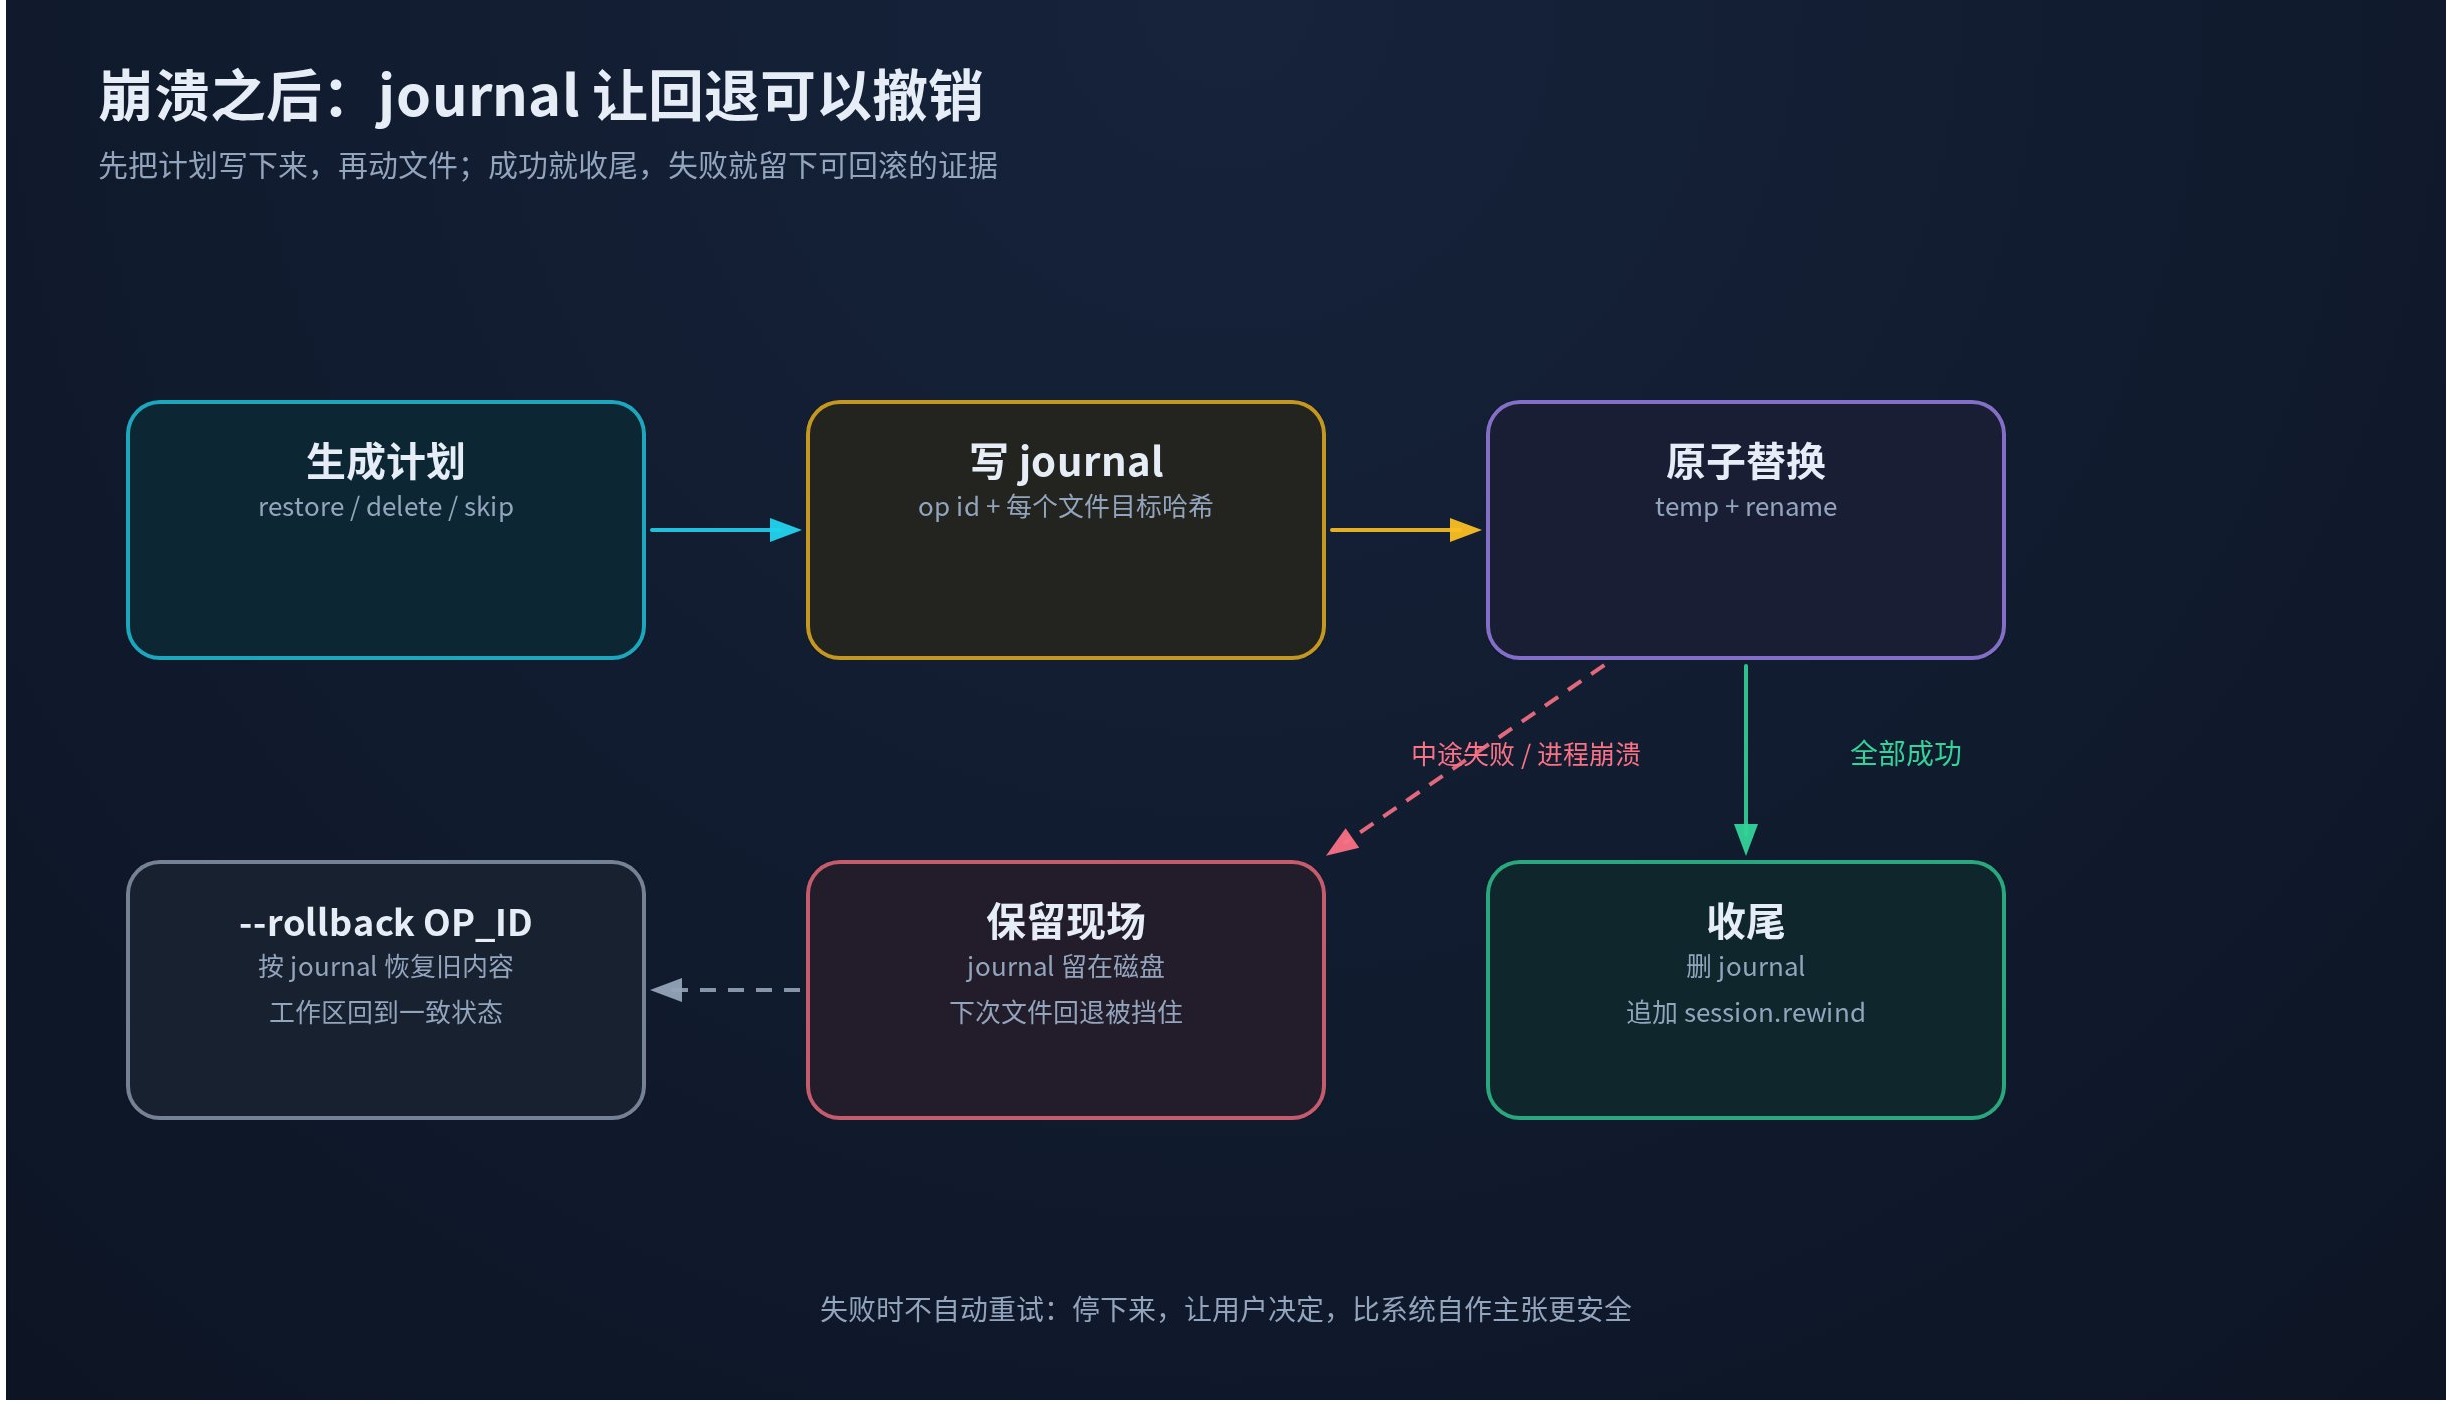
这里有个反直觉的选择:失败时不「自动重试到成功」,而是停下来、保留现场。因为回退本身是危险操作,自动重试可能把用户想保留的中间状态覆盖掉;停下来让用户决定,比系统自作主张更安全。
工程过程:真正花时间的不是算法
核心功能写完得比预想快,剩下的时间几乎都花在「证明它对」上。这部分可能比设计本身更有参考价值。
第一,拆分阶段,接口先行。 先把 orca-rewind 这个独立 crate 的 store/planner/applier 接口和测试立起来,再接 runtime、TUI、CLI。四个并行开发的 agent 各拿一块:存储层、转录记录、runtime 接入、TUI 交互,最后主线合入。接口稳了之后,各块的返工很少;反过来,先写 UI 再改数据结构会非常痛苦。
第二,磁盘是共享资源。 构建目录一度堆到 49G,target/debug/incremental 单独就有 5G,机器只剩 1.3G 可用时,编译直接 ENOSPC 失败。后面的规则变成:统一 CARGO_TARGET_DIR、关掉 incremental、删掉旧 worktree 的 target、不同时跑两个全量测试。这个教训与 rewind 无关,但它是真实项目里最容易忽略成本。
第三,CI 上的偶发失败,先分清是谁的问题。 发布前的 Windows ARM64 全量测试挂在一个 TCP 重试测试上(orca-provider 里既有的测试,和这次改动无关)。第一反应容易是「改一下让它过」,但正确做法是先确认这是 flake:同一棵树在 PR 的 ARM64 任务里已经通过,重跑失败任务后也通过。最后我们在 release 记录里如实写了「首轮 flake、rerun 通过」,而不是悄悄跳过。
第四,发布门禁本身也是代码。 这个仓库用「reviewed artifacts」把协议契约钉死:manifest 里记录每个字段的行号、枚举数量、文件摘要。新增一个 session.rewind 事件,就要同步 EventType 的行号、source_facts 数量、TUI UserAction 的数量、Windows 平台边界的清单、还有 manifest 的 digest。漏一处,validate-runtime-surface-contract 就会在 CI 里报错。最初觉得繁琐,后来发现它逼着我们把「为什么改这里」写清楚,比口头约定可靠得多。
还有一个很小但典型的坑:测试里写了 PathBuf::from("/tmp/project"),在 macOS 上没事,到了 Windows 平台边界检查里就变成「不可移植的测试夹具」。改用临时目录或相对路径之后,跨平台测试才真正可复现。
如果重来一次,我会早点做的几件事
- 先定事实来源和边界,再写代码。 transcript 负责关系、blob 负责内容、runtime 负责状态机;这三件事定下来,后面所有模式都是组合。
- 危险路径先做成两阶段。 写文件、删文件、回滚都走同一个 journal,先保证失败可控,再谈功能。
- 平台差异从第一天当成契约。 条件编译、路径处理、测试夹具,不要等到 CI 在 Windows 上挂才想起来。
- 用真实 runtime 的 e2e 覆盖跨层路径。 mock 能证明「调用了摘要器」,但只有真实 hosted runtime 的测试能证明「dry-run 不调用模型、apply 会写 transcript、成本会记账」。
- 发布流程也当产品做。 版本号三处、官网三处、tag 必须等于 main、check-runs 必须挂在同一个 SHA 上——这些不是形式,它们决定用户拿到的到底是不是你验证过的那份二进制。
结果
v0.5.19 已经发布,/rewind 在 TUI 里可以按轮次回退,orca rewind 在命令行里支持 --at、--last、--mode、--dry-run、--rollback、--prune,也可以从 session.rewind 事件观察每一次回退。检查点默认保留最近 100 个,超过之后自动淘汰并 GC,[rewind] 配置可以关掉捕获或调整保留数量。
这台「后悔药」真正解决的问题不是「让 Agent 不犯错」,而是「让犯错之后有一个可控、可解释、可回滚的出口」。对 Coding Agent 来说,这可能是比「更聪明」更基础的一项能力。
相关阅读:放宽权限的那一刻,正在跑的工具该不该变强? 讲了另一个方向的运行时边界;Agent 工程的五层骨架 则从整体结构看这类能力应该放在哪一层。
Keep Reading
Discussion
Discussion loads when you reach this section.